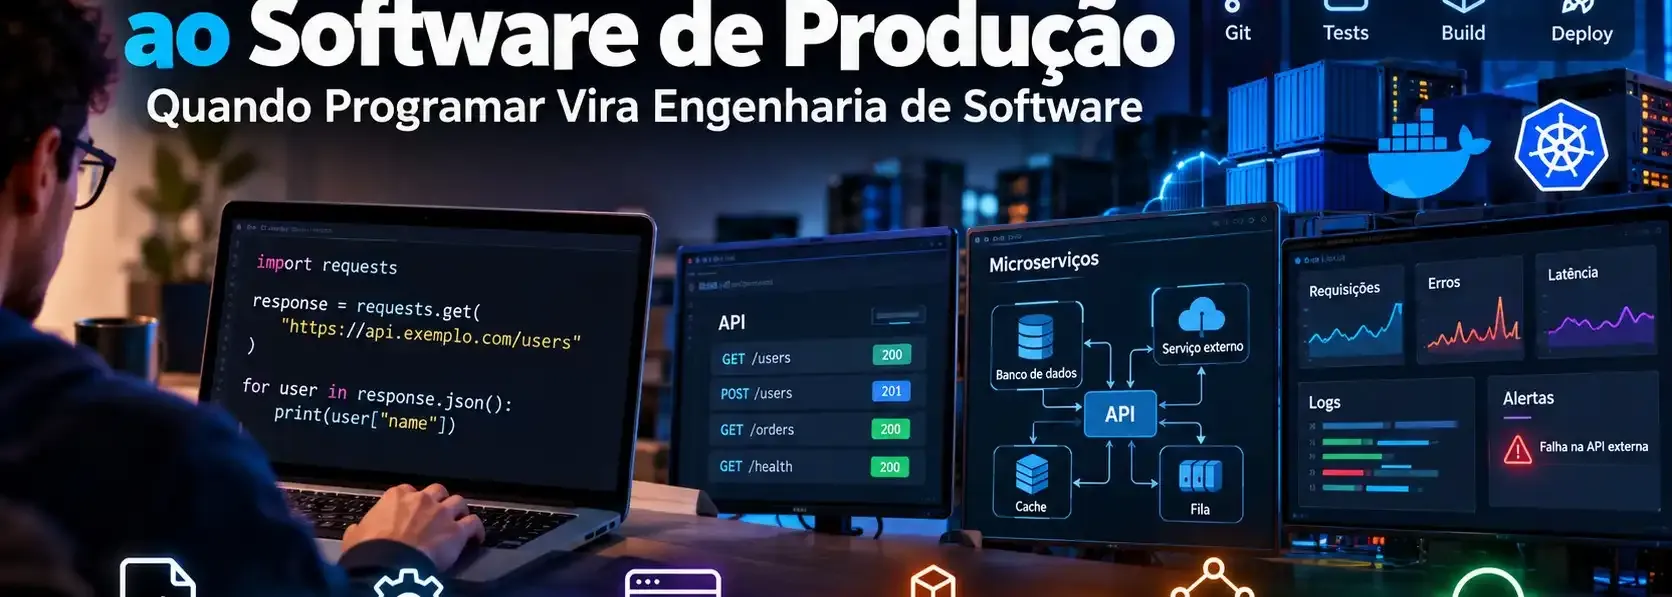
Do script à engenharia de software: quando um código Python deixa de ser apenas um script?
- #Docker
- #Flask
- #Django
- #Python
- #REST
- #FastAPI
- #DevOps
- #API
Você escreveu um script em Python.
Ele funciona.
Você executa, recebe o resultado esperado e pensa:
"Pronto."
Até que alguém pergunta:
- E se der erro?
- Como sabemos o que aconteceu?
- Como testamos isso automaticamente?
- Como configuramos desenvolvimento, homologação e produção?
- O que acontece se precisarmos executar isso 100 vezes ao mesmo tempo?
- Onde ficam as credenciais?
- Como fazemos o deploy?
- Como monitoramos a aplicação?
- Como recuperamos uma falha?
- E se outro desenvolvedor precisar manter esse código daqui a seis meses?
É nesse momento que começa a diferença entre escrever código e construir software.
1. Tudo começa com um script
Imagine um código simples:
import requests

response = requests.get("https://api.exemplo.com/users")

for user in response.json():
  print(user["name"])
Funciona.
Para um script pessoal, uma prova de conceito ou uma automação rápida, talvez isso seja suficiente.
Mas, quando esse código começa a fazer parte de um sistema real, surgem outras perguntas:
- O que acontece se a API estiver indisponível?
- E se ela retornar HTTP 500?
- E se o JSON vier em um formato diferente?
- Quanto tempo devemos esperar por uma resposta?
- Devemos tentar novamente?
- Quantas vezes?
- Onde registramos o erro?
- Como testamos esse comportamento?
- Como sabemos que o problema aconteceu?
A partir daqui, o problema deixa de ser apenas "escrever Python".
2. O script vira uma automação
Quando esse código passa a executar uma tarefa recorrente, novas preocupações aparecem.
Agora precisamos pensar em:
- tratamento de exceções
- logs
- configuração
- idempotência
- retries
- timeouts
- validação de dados
- agendamento
- tratamento de falhas
Um código que funciona uma vez é muito diferente de um código que precisa funcionar todos os dias às 03:00 sem que ninguém precise ficar olhando para ele.
Essa diferença parece pequena.
Na prática, é gigantesca.
3. A automação vira uma API
Em algum momento, outras aplicações podem precisar consumir aquela funcionalidade.
Talvez seja hora de transformar a lógica em um serviço.
Entram conceitos como:
- FastAPI, Django ou Flask
- contratos de API
- autenticação
- autorização
- validação
- versionamento
- HTTP status codes
- documentação
- gerenciamento de dependências
Agora não basta o código funcionar.
Ele precisa ter um contrato claro e previsível com outros sistemas.
Por exemplo:
POST /users
Pode receber:
{
  "name": "Ilton",
  "email": "ilton@example.com"
}
E retornar:
{
  "id": 123,
  "name": "Ilton",
  "email": "ilton@example.com"
}
A partir desse momento, mudanças aparentemente simples podem quebrar consumidores.
A API passou a ter responsabilidade.
4. O serviço começa a conversar com outros serviços
É aqui que a complexidade começa a crescer rapidamente.
Podemos ter algo assim:
            ┌──────────────┐
            │     API      │
            └──────┬───────┘
                   │
     ┌─────────────┼─────────────┐
     │             │             │
     ▼             ▼             ▼
 ┌───────┐    ┌──────────┐   ┌───────┐
 │ Banco │    │ API      │   │ Cache │
 │       │    │ Externa  │   │ Redis │
 └───────┘    └──────────┘   └───────┘
                   │
                   ▼
               ┌───────┐
               │ Fila  │
               └───────┘
Agora aparecem problemas que simplesmente não existiam no script original.
O banco caiu.
A API externa está lenta.
A mensagem foi processada duas vezes.
O usuário enviou a mesma requisição três vezes.
Um serviço está sobrecarregado.
Uma operação demorou 20 segundos.
Uma mensagem ficou presa na fila.
E agora?
É nesse ponto que conceitos como:
- filas
- mensageria
- concorrência
- cache
- circuit breaker
- retries
- idempotência
- sistemas distribuídos
começam a fazer parte do problema.
5. Código de produção precisa ser observável
Um dos maiores sinais de maturidade em engenharia de software, na minha opinião, é entender que:
Se você não consegue descobrir o que aconteceu, você não controla o sistema.
Logs estruturados, métricas, traces, alertas e monitoramento deixam de ser apenas "coisas de DevOps".
Eles passam a fazer parte do próprio software.
Não basta saber que algo falhou.
Precisamos conseguir responder:
O que falhou?
Quando aconteceu?
Por que aconteceu?
Qual requisição estava sendo processada?
Qual serviço estava envolvido?
Quantas vezes aconteceu?
Qual foi o impacto?
Por exemplo, um log como:
Erro ao processar pagamento
é muito menos útil do que:
{
  "event": "payment_processing_failed",
  "order_id": 12345,
  "user_id": 987,
  "service": "payment-api",
  "error": "timeout",
  "duration_ms": 5021
}
O segundo formato permite investigar o problema.
O primeiro apenas diz que alguém está tendo um dia ruim.
6. Testes deixam de ser opcionais
Um script de 100 linhas pode ser alterado manualmente.
Um sistema utilizado por milhares de pessoas não deveria depender disso.
É aqui que entram diferentes níveis de testes:
      Testes Unitários
             ↓
     Testes de Integração
             ↓
     Testes de Contrato
             ↓
            CI
             ↓
          Deploy
O objetivo não é escrever testes porque "todo projeto precisa ter testes".
O objetivo é criar uma rede de segurança para que o software possa evoluir sem quebrar o que já funciona.
Um teste bem escrito permite mudar uma implementação inteira e descobrir rapidamente se algum comportamento importante foi quebrado.
7. Docker muda a conversa
Em algum momento aparece uma pergunta clássica:
"Mas funciona na minha máquina."
Docker ajuda justamente a reduzir esse tipo de problema.
Podemos definir de maneira reproduzível:
- ambiente
- dependências
- versão do Python
- serviços necessários
- configurações
- processo de execução
Em vez de depender da máquina específica do desenvolvedor, passamos a ter uma definição explícita do ambiente necessário para executar a aplicação.
Por exemplo:
Código
+
Dependências
+
Python
+
Configuração
↓
Container
Isso torna o processo de desenvolvimento, testes e deploy muito mais previsível.
8. CI/CD fecha o ciclo
Depois disso, podemos automatizar o caminho entre código e produção:
Git Push
 ↓
Lint
 ↓
Testes
 ↓
Build
 ↓
Docker Image
 ↓
Deploy
 ↓
Monitoramento
A ideia não é simplesmente:
"Automatizar o deploy."
É criar um processo repetível, previsível e confiável para entregar software.
Se o processo depende de alguém lembrar de executar cinco comandos manualmente toda sexta-feira às 18h, provavelmente temos uma oportunidade de melhoria.
9. E então chegamos à Engenharia de Software
O mais interessante é perceber que nada disso aconteceu porque Python mudou.
O Python continuou sendo Python.
O que mudou foi o problema que estamos tentando resolver.
Podemos representar essa evolução assim:
Script
↓
Automação
↓
API
↓
Serviço
↓
Sistema distribuído
↓
Software preparado para produção
E cada etapa adiciona novas responsabilidades.
Não necessariamente precisamos passar por todas elas.
Mas, conforme o impacto do software aumenta, algumas dessas preocupações deixam de ser opcionais.
10. Afinal, quando um código Python deixa de ser apenas um script?
Não existe um número mágico de linhas.
Não é quando o projeto começa a usar FastAPI.
Não é quando colocamos Docker.
Também não é quando aparecem filas, microsserviços ou Kubernetes.
Um código deixa de ser apenas um script quando passa a carregar responsabilidades que vão além de simplesmente executar uma tarefa.
Quando outras aplicações dependem dele.
Quando dados importantes passam por ele.
Quando uma falha pode gerar impacto para usuários ou para o negócio.
Quando precisamos garantir que ele continue funcionando amanhã, na próxima semana e daqui a seis meses.
É nesse momento que práticas como:
- testes
- logs
- observabilidade
- segurança
- tratamento de falhas
- CI/CD
- arquitetura
- escalabilidade
deixam de ser "extras".
Elas passam a fazer parte do próprio software.
11. Complexidade também precisa ser uma decisão
Existe, porém, um detalhe importante.
Engenharia de software não significa transformar todo script em uma arquitetura distribuída com 14 microsserviços, Kafka, Kubernetes e uma reunião para decidir o nome do endpoint.
Um script de 50 linhas pode ser exatamente a solução certa.
Se ele resolve o problema, é fácil de entender, possui os cuidados necessários e não precisa de uma arquitetura maior, não existe motivo para complicá-lo.
O problema aparece nos dois extremos.
De um lado:
"É só um script."
E colocamos um sistema crítico em produção sem testes, logs, tratamento de erros ou monitoramento.
Do outro:
"Precisamos de Kubernetes."
E criamos uma infraestrutura gigantesca para executar um código que poderia ser um cron job.
A maturidade está em saber qual nível de engenharia o problema realmente exige.
12. A pergunta que realmente importa
No começo, a pergunta era:
"Meu código funciona?"
Depois de algum tempo trabalhando com software, talvez a pergunta mais importante passe a ser:
"Meu software continua funcionando quando as coisas dão errado?"
Porque sistemas reais falham.
Redes falham.
Bancos falham.
APIs externas falham.
Servidores falham.
Usuários fazem coisas inesperadas.
Desenvolvedores cometem erros.
Deploys dão errado.
E software de produção precisa estar preparado para lidar com essas situações.
Conclusão
Escrever Python é saber programar.
Construir software confiável é saber fazer engenharia de software.
A diferença não está necessariamente na quantidade de código.
Está nas responsabilidades que aquele código passou a carregar.
Um pequeno script pode continuar sendo um pequeno script durante anos.
Uma aplicação aparentemente simples pode, por outro lado, se transformar em um componente crítico de um ecossistema inteiro.
O ponto não é adicionar complexidade.
É adicionar as ferramentas e práticas certas quando o problema exige.
No fim, talvez essa seja uma das principais transições na carreira de um desenvolvedor:
Você deixa de pensar apenas em:
"Como faço esse código funcionar?"
E começa a pensar em:
"Como faço esse software continuar funcionando, ser observável, testável, seguro e sustentável quando eu não estiver olhando para ele?"
É aí que programação começa a virar engenharia de software.