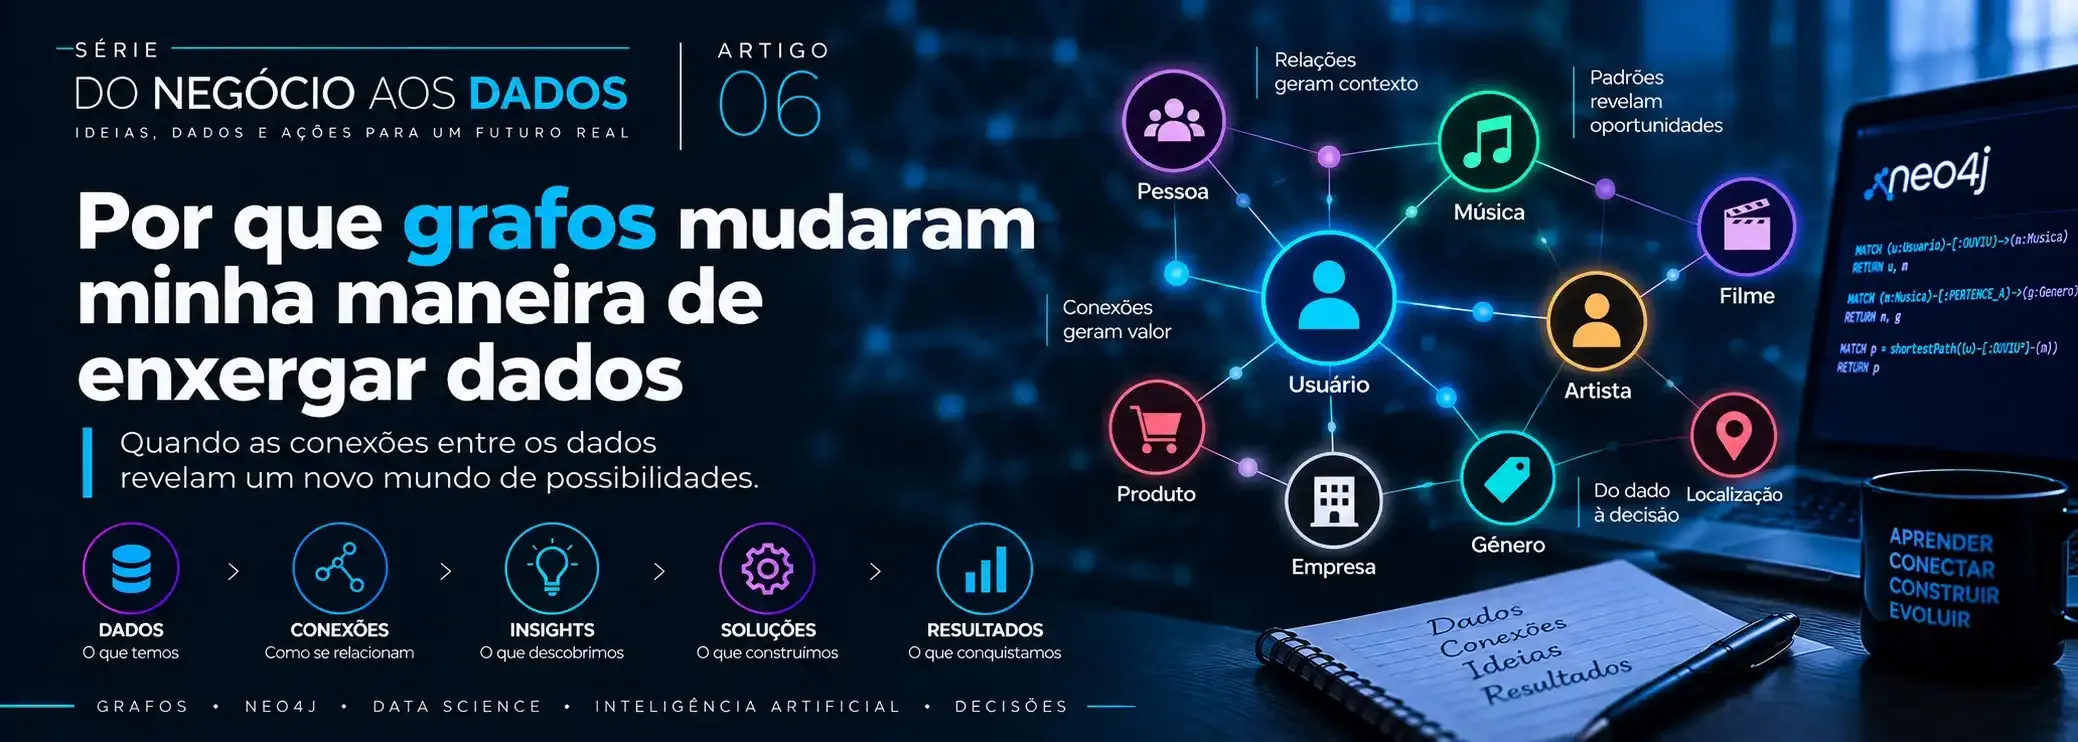
Por que grafos mudaram minha maneira de enxergar dados
- #Machine Learning
- #Python
- #Neo4J
- #Banco de Dados
Durante boa parte da minha jornada em Dados, aprendi a trabalhar com informações organizadas principalmente em linhas, colunas, tabelas e atributos.
Clientes possuem características. Produtos possuem características. Transações possuem características.
Esse modelo é extremamente poderoso e continua sendo a solução adequada para inúmeros problemas.
Mas, conforme avancei nos estudos — especialmente ao trabalhar com Neo4j, Cypher e Graph Data Science — comecei a perceber algo diferente:
Em muitos problemas, o valor não está apenas nos dados que descrevem cada elemento. Está nas relações entre eles.
Essa percepção mudou minha maneira de enxergar dados.
🔗 De tabelas para conexões
Imagine uma plataforma de streaming.
Em um modelo relacional, poderíamos ter tabelas como:
Usuários
id_usuario | idade | cidade | plano
Músicas
id_musica | titulo | artista | genero
Interações
id_usuario | id_musica | data | tipo_interacao
É uma estrutura perfeitamente válida.
Para descobrir quais músicas determinado usuário ouviu, poderíamos relacionar essas tabelas utilizando suas chaves.
Em um grafo, entretanto, podemos representar o mesmo domínio de outra maneira:
(Usuário)-[:OUVIU]->(Música)
(Música)-[:INTERPRETADA_POR]->(Artista)
(Música)-[:PERTENCE_A]->(Gênero)
(Usuário)-[:SEGUE]->(Artista)
Agora, além das entidades, as relações tornam-se elementos explícitos do modelo.
E isso muda as perguntas que podemos fazer aos dados.
🧩 Nodes, Relationships, Labels e Properties
No modelo de Property Graph, utilizado pelo Neo4j, alguns conceitos são fundamentais.
Nodes
Representam as entidades do domínio:
Usuário
Música
Artista
Produto
Cliente
Empresa
Relationships
Representam as conexões:
OUVIU
SEGUE
COMPROU
PERTENCE_A
CONHECE
TRANSFERIU_PARA
Labels
Classificam os nós:
(:Usuario)
(:Musica)
(:Artista)
Properties
Armazenam atributos associados aos elementos:
(:Musica {
  titulo: "Example",
  ano: 2026
})
Um relacionamento também pode possuir propriedades:
(:Usuario)-[:OUVIU {
  vezes: 15
}]->(:Musica)
Isso é particularmente interessante porque o relacionamento também passa a carregar informação.
🧠 O relacionamento também é dado
Essa foi uma das ideias que mais me chamou atenção.
Em bancos relacionais, normalmente armazenamos entidades em tabelas e reconstruímos suas relações utilizando chaves e operações como JOIN.
No grafo, a conexão faz parte diretamente do modelo.
Conceitualmente, deixamos de perguntar apenas:
Quais são as características desse elemento?
e passamos também a perguntar:
Como esse elemento está conectado aos demais?
Isso abre espaço para perguntas como:
- Quais clientes apresentam comportamentos semelhantes?
- Quais produtos são frequentemente comprados pelos mesmos clientes?
- Quais usuários possuem interesses próximos?
- Como duas entidades estão conectadas?
- Quais elementos ocupam posições importantes em uma rede?
- Quais comunidades surgem naturalmente?
- Que produto, filme ou música poderia ser recomendado?
Quando as relações fazem parte do problema, grafos começam a se tornar particularmente interessantes.
⚙️ Criando um pequeno grafo com Cypher
Podemos representar um domínio simples utilizando Cypher.
Por exemplo:
CREATE (u:Usuario {nome: 'Marcus'})
CREATE (m:Musica {titulo: 'Music A'})
CREATE (a:Artista {nome: 'Artist A'})

CREATE (u)-[:OUVIU]->(m)
CREATE (m)-[:INTERPRETADA_POR]->(a)
Visualmente, temos:
Marcus → OUVIU → Music A → INTERPRETADA_POR → Artist A
Mas podemos começar a criar outras conexões:
MATCH (u:Usuario {nome: 'Marcus'})
MATCH (m:Musica {titulo: 'Music B'})
CREATE (u)-[:OUVIU]->(m)
O grafo começa a representar o comportamento do usuário.
🔎 Consultando padrões com MATCH
Uma das características que achei mais intuitivas no Cypher é a maneira como os padrões são representados.
Para encontrar músicas ouvidas por usuários:
MATCH (u:Usuario)-[:OUVIU]->(m:Musica)
RETURN u.nome, m.titulo
A própria consulta representa visualmente:
Usuário → OUVIU → Música
Podemos avançar um pouco.
Imagine que queremos descobrir usuários que ouviram a mesma música:
MATCH (u1:Usuario)-[:OUVIU]->(m:Musica)<-[:OUVIU]-(u2:Usuario)
WHERE u1 <> u2
RETURN u1.nome, m.titulo, u2.nome
Agora estamos buscando um padrão de relacionamento.
Isso começa a ficar especialmente interessante quando o número de conexões cresce.
🕸️ De consultas para estruturas de rede
Imagine milhares de usuários conectados a milhares de músicas.
Cada interação cria novas relações.
Passamos a ter uma rede:
Usuário ──OUVIU──────► Música
 │                      │
 │                      │
 SEGUE              PERTENCE_A
 │                      │
 ▼                      ▼
Artista                 Gênero
A partir dessa estrutura, podemos investigar muito mais do que registros individuais.
Podemos procurar:
caminhos, comunidades, similaridade, influência e padrões de conexão.
É nesse ponto que entramos em Graph Data Science.
📊 Graph Data Science
O Neo4j Graph Data Science amplia a análise ao permitir a aplicação de algoritmos sobre a estrutura do grafo.
Algumas famílias de problemas são particularmente interessantes.
Centralidade
Busca identificar quais nós possuem maior importância estrutural em determinada rede.
Dependendo do problema, podemos utilizar algoritmos como:
Degree Centrality, PageRank e Betweenness Centrality.
Uma aplicação poderia ser descobrir quais elementos exercem maior influência dentro de uma rede.
Community Detection
Procura identificar grupos de nós fortemente conectados.
Algoritmos como Louvain podem ajudar a revelar comunidades que não estavam explicitamente definidas nos dados originais.
Em uma plataforma musical, por exemplo, comunidades poderiam revelar grupos de usuários com padrões de consumo semelhantes.
Similaridade
Podemos procurar elementos que apresentam padrões de conexão próximos.
Por exemplo:
Usuário A → Música 1
        → Música 2
        → Música 3

Usuário B → Música 1
        → Música 2
        → Música 4
Os usuários A e B possuem parte de seus interesses em comum.
Essa estrutura pode servir de base para uma pergunta:
Se usuários com comportamento semelhante consumiram determinados conteúdos, podemos utilizar essas relações para gerar recomendações?
E aqui começamos a chegar ao próximo projeto da série.
🛣️ Pathfinding
Outra classe de algoritmos trabalha com caminhos.
Uma pergunta clássica seria:
Qual é o menor caminho entre dois elementos da rede?
Dependendo do domínio, isso pode ser útil em:
- logística;
- telecomunicações;
- redes sociais;
- análise de dependências;
- fraude;
- sistemas de conhecimento.
O ponto importante é que o caminho entre entidades pode possuir significado próprio.
💡 Grafos não substituem bancos relacionais
Quanto mais estudo novas tecnologias, mais considero importante evitar uma armadilha:
usar uma tecnologia simplesmente porque aprendemos a utilizá-la.
Grafos não substituem bancos relacionais.
Eles são especialmente adequados quando as conexões entre os dados são parte central do problema.
Da mesma maneira:
Machine Learning não é necessário para toda análise.
IA Generativa não é necessária para todo processo.
Grafos não são necessários para todo banco de dados.
A pergunta deve vir antes da tecnologia:
Que problema estamos tentando resolver?
🎯 Do armazenamento para a decisão
Esse aprendizado também reforçou uma ideia que venho desenvolvendo ao longo da série Do Negócio aos Dados.
Dados não geram valor apenas porque foram armazenados.
Precisamos transformá-los em conhecimento capaz de apoiar uma ação.
Com grafos, comecei a enxergar uma nova sequência:
Entidades → Relações → Padrões → Insights → Decisão
Ou, olhando pela perspectiva do negócio:
Problema → Dados → Conexões → Análise → Insight → Solução → Resultado
Essa mudança foi importante porque passei a olhar para um dataset de duas maneiras.
Não apenas:
O que cada elemento possui?
Mas também:
Com o que cada elemento está conectado?
🚀 E então surgiu uma nova pergunta
Depois de estudar modelagem de grafos, Cypher, caminhos, similaridade, centralidade, comunidades e Graph Data Science, surgiu uma oportunidade natural de transformar o aprendizado em projeto.
A pergunta foi:
Seria possível utilizar as relações entre usuários, músicas, artistas e gêneros para construir um sistema de recomendação?
Em vez de simplesmente estudar os algoritmos isoladamente, decidi testar essa ideia na prática.
O resultado foi um projeto utilizando Neo4j + Cypher + Graph Data Science para explorar relações e construir recomendações a partir das conexões existentes nos dados.
Mas esse será o tema do próximo artigo.
🔜 Próximo artigo
De relações a recomendações: construindo um sistema de recomendação musical com Graph Data Science
Nele, quero sair dos conceitos apresentados aqui e mostrar a aplicação:
modelagem → grafo → Cypher → similaridade → recomendação.
Porque uma das partes mais interessantes de aprender tecnologia é justamente o momento em que o conceito deixa o material de estudo e começa a resolver um problema.
Grafos mudaram minha maneira de enxergar dados porque me ensinaram que, muitas vezes, a informação mais importante não está apenas nos elementos — está na maneira como eles se relacionam.
E talvez essa seja a pergunta que eu passei a fazer com mais frequência:
E se a resposta estiver nas conexões?
Negócio + Dados + IA = Decisões melhores, mais rápidas e com maior impacto.
💬 E você?
Já trabalhou com Neo4j, Cypher ou Graph Data Science?
Em que tipo de problema você acredita que analisar conexões pode revelar algo que uma abordagem tradicional dificilmente mostraria?
#Neo4j #GraphDataScience #Cypher #DataScience #Grafos #MachineLearning #DataAnalytics #Python #BancoDeDados #InteligenciaArtificial