
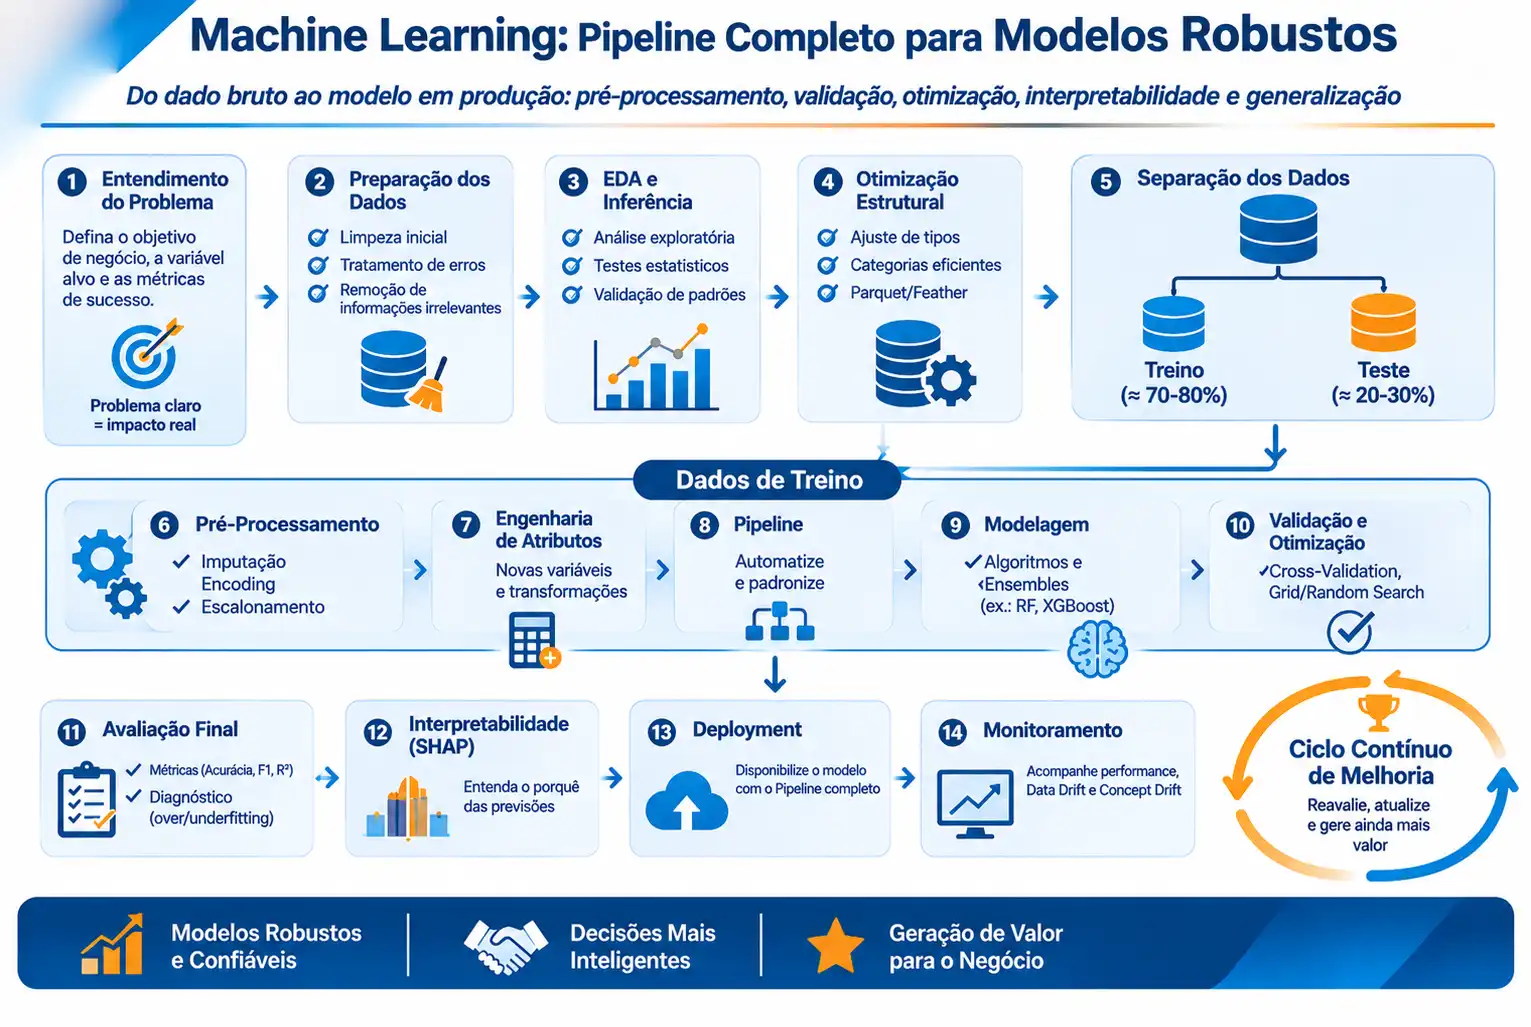
Machine Learning: Pipeline Completo para Modelos Robustos
Do dado bruto ao modelo em produção: pré-processamento, validação, otimização, interpretabilidade e generalização
1. Entendimento do Problema e dos Dados
Todo projeto de Machine Learning começa pelo entendimento do negócio, definição da variável alvo (target), fontes de dados e objetivo final. Antes de pensar em algoritmos, é necessário responder: qual problema está sendo resolvido? Trata-se de classificação, regressão ou segmentação? Nessa fase também são identificadas restrições operacionais, métricas de sucesso e critérios de negócio que irão orientar todo o desenvolvimento do modelo.
O objetivo final de um projeto de Machine Learning não é construir o modelo mais complexo, mas gerar valor de negócio através de previsões confiáveis, explicáveis e capazes de generalizar para dados futuros.
Por isso, a compreensão do problema de negócio deve sempre preceder as decisões técnicas, garantindo que o modelo produza impacto real e não apenas bons resultados métricos.
2. Limpeza Inicial Antes da Separação dos Dados
Ainda com o dataset completo, realiza-se apenas uma limpeza segura dos dados. Remove-se duplicidades, colunas sem valor analítico (IDs, códigos únicos, nomes completos), colunas constantes (por exemplo, uma coluna "Estado" contendo apenas "SP") e corrige-se erros evidentes de digitação como "Sãu Paulo" para "São Paulo". Essas atividades não utilizam estatísticas da amostra e, portanto, não geram vazamento de informação para o futuro.
3. Análise Exploratória (EDA) e Inferência Estatística Inicial
Antes da divisão dos dados, executa-se a EDA utilizando histogramas, boxplots, correlações, análise de distribuições e identificação de outliers. É neste momento que a Estatística Inferencial entra em cena através de testes de hipóteses, ANOVA, Qui-Quadrado e t-test. O objetivo é verificar se os padrões observados possuem significado estatístico ou se são apenas ruído da amostra. O p-valor ajuda a validar se uma variável realmente merece entrar no modelo ou se sua influência é resultado do acaso.
4. Otimização Estrutural dos Dados
Antes da modelagem, também é recomendável otimizar o armazenamento dos dados. Colunas do tipo object com baixa cardinalidade devem ser convertidas para category, especialmente variáveis como estados, gênero, faixas de renda ou categorias de produtos. Da mesma forma, tipos numéricos como int64 podem ser convertidos para int8 ou int16 quando possível. Em bases grandes, essa simples prática pode reduzir drasticamente o consumo de memória. Para persistência dos dados, dê preferência ao Parquet ou Feather, pois CSV não preserva metadados como category.
5. Separação em Treino e Teste
Somente após a limpeza inicial e a EDA realiza-se o train_test_split. O conjunto de treino será utilizado para aprendizado, enquanto o conjunto de teste permanecerá completamente isolado até a avaliação final. Em classificação, especialmente em bases desbalanceadas, recomenda-se utilizar stratify para manter as mesmas proporções das classes nos dois conjuntos. Não existe obrigação de treino e teste terem exatamente a mesma quantidade de linhas; o importante é manter a representatividade estatística da amostra.
6. Pré-Processamento Exclusivo do Treino
Após a separação dos dados, todas as transformações que aprendem padrões devem ser realizadas exclusivamente no conjunto de treino. Isso inclui imputação de valores ausentes, escalonamento, encoding e criação de atributos. O fit aprende as regras e o transform aplica essas regras. Portanto, usa-se fit_transform apenas no treino e somente transform nos dados de teste e em dados futuros. Jamais execute um novo fit no teste, pois isso caracteriza Data Leakage e invalida completamente a avaliação.
7. Imputação, Encoding e Engenharia de Atributos
Valores ausentes podem ser tratados com SimpleImputer utilizando média, mediana ou moda. Variáveis nominais normalmente utilizam OneHotEncoder, preferencialmente com drop='first' em modelos lineares para evitar multicolinearidade. LabelEncoder é mais indicado para o target e TargetEncoder pode ser uma excelente alternativa em variáveis categóricas de alta cardinalidade. Quando relações não lineares são importantes, PolynomialFeatures pode criar interações e potências capazes de aumentar significativamente o poder preditivo do modelo.
8. Escalonamento dos Dados
A escolha do scaler depende da natureza dos dados e do algoritmo. O MinMaxScaler normaliza os valores geralmente para o intervalo entre 0 e 1, sendo muito usado em redes neurais. O StandardScaler centraliza os dados em média zero e desvio padrão um, favorecendo modelos lineares, PCA e SVM. Já o RobustScaler utiliza mediana e intervalo interquartílico (IQR), tornando-se a melhor alternativa quando existem muitos outliers. Em projetos reais, frequentemente vale testar os três dentro da validação cruzada.
9. Construção do Pipeline
A melhor prática moderna é encapsular todas as transformações dentro de um Pipeline ou ColumnTransformer. O Pipeline garante que o mesmo tratamento aplicado no treino seja replicado automaticamente em teste e produção, eliminando o risco de inconsistências. Quando chamamos pipeline.fit(), o Scikit-Learn executa internamente todos os fit_transform necessários. Quando chamamos predict(), ele utiliza apenas transform, protegendo o fluxo contra vazamento de dados.
10. Escolha dos Algoritmos
Entre os algoritmos supervisionados mais relevantes estão Regressão Linear, Regressão Logística, KNN, SVM, Árvores de Decisão, Random Forest, XGBoost e LightGBM. Para aprendizado não supervisionado destacam-se K-Means, PCA e DBSCAN. Em projetos corporativos modernos, especialmente em problemas tabulares, os modelos baseados em árvores geralmente superam métodos lineares em capacidade preditiva e robustez.
11. Ensemble Tree-Based Models: O Padrão da Indústria
O Random Forest utiliza Bagging, treinando centenas de árvores independentes para reduzir variância e aumentar estabilidade. Os hiperparâmetros mais importantes são n_estimators (300 a 1000), max_depth, min_samples_leaf e max_features. Já o XGBoost e o LightGBM utilizam Boosting, onde cada árvore corrige os erros da anterior. Seus principais hiperparâmetros são learning_rate, n_estimators, max_depth, subsample, colsample_bytree (XGBoost) e num_leaves (LightGBM). Na prática profissional, learning_rate=0.01 é frequentemente considerado o melhor equilíbrio entre performance e estabilidade, enquanto 0.001 é extremamente conservador e costuma ser utilizado quando se busca máxima generalização combinada com grande quantidade de árvores e Early Stopping.
12. Modelos Combinados e Stacking
Após encontrar bons modelos individuais, organizações maduras frequentemente utilizam Stacking. Essa técnica combina as previsões de múltiplos algoritmos, como Random Forest, XGBoost e LightGBM, treinando um meta-modelo sobre suas saídas. O objetivo é explorar forças complementares de diferentes abordagens e reduzir erros específicos de cada algoritmo. Em competições Kaggle e ambientes corporativos de alta performance, o Stacking frequentemente produz resultados superiores aos obtidos por qualquer modelo isolado.
13. Validação Cruzada, Busca de Hiperparâmetros e Controle de Overfitting
A avaliação não deve depender de uma única divisão treino-teste. Cross-Validation permite estimar a capacidade de generalização em múltiplos folds. O GridSearchCV realiza busca exaustiva dos hiperparâmetros, enquanto o RandomizedSearchCV explora o espaço de busca de forma muito mais eficiente. Além da média dos folds, é essencial analisar o desvio padrão. Um modelo com 88% ± 1% normalmente é muito mais confiável do que outro com 91% ± 10%. Técnicas como Ridge (L2), LASSO (L1), Elastic Net e Early Stopping são fundamentais para controlar o overfitting.
14. Avaliação Final e Testes de Generalização
Somente após finalizar a modelagem avalia-se o conjunto de teste, que permaneceu isolado durante todo o processo. Em classificação utiliza-se confusion_matrix, classification_report, Precisão, Recall, Acurácia, F1-Score e ROC AUC. Em regressão utiliza-se MAE, MSE, RMSE e R². O diagnóstico mais importante consiste em comparar os resultados de treino e teste. Se o treino apresenta desempenho muito superior ao teste, há forte evidência de overfitting. Se ambos apresentam desempenho baixo, provavelmente há underfitting ou insuficiência de atributos relevantes.
15. Interpretabilidade (SHAP)
Após a avaliação final do modelo, inicia-se a etapa de interpretabilidade. O SHAP (SHapley Additive Explanations) é atualmente considerado o padrão ouro para explicação de modelos de Machine Learning, permitindo quantificar exatamente quanto cada variável contribuiu para cada previsão. Enquanto as métricas de avaliação mostram o nível de desempenho do modelo, o SHAP explica os motivos por trás das decisões tomadas. Essa camada de transparência é especialmente importante em setores regulados, como bancos, saúde e governo.
O SHAP pode ser utilizado tanto no conjunto de treino quanto no conjunto de teste. No treino, auxilia na compreensão global do comportamento do modelo e na identificação das variáveis mais importantes para o aprendizado. Já no conjunto de teste, permite verificar se as explicações permanecem consistentes em dados nunca vistos anteriormente, oferecendo uma visão mais realista da capacidade de generalização do modelo. Em ambientes produtivos, a prática mais comum é aplicar SHAP sobre os dados de teste e posteriormente sobre dados reais provenientes da produção.
Além de fornecer explicações locais para previsões individuais, o SHAP também permite análises globais, revelando quais variáveis mais influenciam o modelo como um todo. Dessa forma, ele transforma modelos complexos em ferramentas transparentes, auditáveis e confiáveis para a tomada de decisão.
16. Deployment e Monitoramento
Após a validação e interpretação do modelo, inicia-se a etapa de deployment, onde a solução é disponibilizada para uso em ambientes reais. O modelo deve ser implantado juntamente com seu Pipeline completo, garantindo que qualquer novo dado receba exatamente o mesmo tratamento aplicado durante o treinamento, preservando consistência, reprodutibilidade e capacidade de generalização.
Entretanto, o ciclo de vida do Machine Learning não termina no deployment. Modelos em produção devem ser continuamente monitorados para identificar degradação de desempenho, mudanças na distribuição dos dados (Data Drift) e alterações na relação entre as variáveis e o alvo (Concept Drift). À medida que o ambiente de negócio evolui, o comportamento dos dados pode mudar, tornando necessária a reavaliação ou o retreinamento do modelo.
O objetivo final é garantir que o modelo permaneça robusto, confiável, explicável e alinhado ao negócio ao longo do tempo, mantendo sua capacidade de gerar valor em cenários reais e dinâmicos.



