VoeBem Analytics AI: Da Engenharia de Dados à IA Generativa com Databricks
- #Databricks
- #PySpark
Como transformei dados públicos da aviação brasileira em um pipeline Medallion com PySpark, Delta Lake, Analytics e Databricks Genie
Introdução
Dados só geram valor quando conseguem percorrer o caminho entre a origem e a decisão.
Foi com essa premissa que desenvolvi o VoeBem Analytics AI, um projeto de Engenharia de Dados, Analytics e Inteligência Artificial que utiliza dados públicos da aviação brasileira disponibilizados pela ANAC — Agência Nacional de Aviação Civil.
O objetivo foi construir uma solução end-to-end: partir dos dados brutos, estruturá-los segundo a Medallion Architecture, desenvolver indicadores analíticos e, finalmente, disponibilizar essas informações por meio de uma camada de Inteligência Artificial capaz de responder perguntas de negócio em linguagem natural.
Para isso, utilizei tecnologias como Databricks, Apache Spark, PySpark, Spark SQL, Delta Lake, Unity Catalog e Databricks Genie.
O resultado não é apenas um conjunto de notebooks. É um pipeline que conecta:
Engenharia de Dados → Analytics → IA Generativa → Insights de Negócio
1. O desafio
Dados de aviação permitem explorar diversas questões relevantes para uma análise operacional:
- Quais companhias concentram maior volume de voos?
- Quais são as rotas mais movimentadas?
- Quais aeroportos apresentam maior número de operações?
- Qual é o comportamento dos atrasos?
- Como o volume de voos evolui ao longo dos meses?
Responder a essas perguntas exige mais do que simplesmente carregar um arquivo em um DataFrame.
É necessário organizar um fluxo que permita ingerir, limpar, transformar, estruturar e agregar os dados, criando uma base confiável para as análises.
Foi justamente esse o papel da arquitetura construída no VoeBem.
2. Arquitetura do projeto
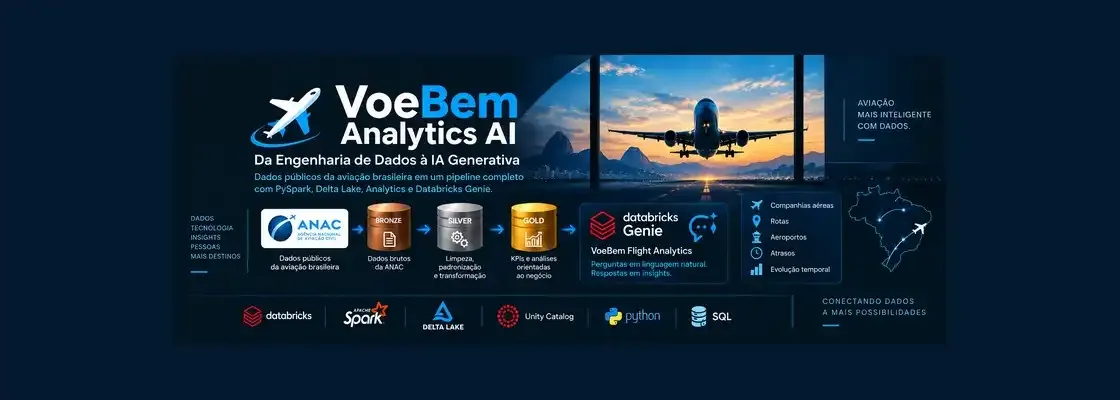
A solução foi estruturada segundo o conceito de Medallion Architecture, separando o processamento em três camadas principais:
ANAC — Dados Abertos
      ↓
   BRONZE
      ↓
   SILVER
      ↓
    GOLD
      ↓
VoeBem Flight Analytics
      ↓
 Databricks Genie
      ↓
Insights em linguagem natural
Essa separação permite que cada etapa tenha uma responsabilidade clara.
A Bronze preserva os dados mais próximos da origem.
A Silver trata e padroniza as informações.
A Gold transforma os dados preparados em indicadores voltados para análise e negócio.
A partir da Gold, entra a camada de Inteligência Artificial.
3. Bronze: começando pelos dados brutos
A primeira etapa foi construir a camada de ingestão.
Os dados utilizados são provenientes de fontes públicas da ANAC e foram organizados no ambiente Databricks.
A camada Bronze tem como princípio preservar os dados recebidos antes das transformações analíticas mais relevantes.
No projeto, essa etapa foi dividida em dois notebooks:
01_Bronze_VRA.ipynb
02_Bronze_Referencias.ipynb
O primeiro trabalha com os dados operacionais de voos, enquanto o segundo prepara informações de referência utilizadas posteriormente no pipeline.
Essa divisão também ajuda a tornar o projeto mais organizado e facilita manutenção, rastreabilidade e evolução.
4. Silver: transformando dados em informação confiável
Com os dados disponíveis na Bronze, o próximo desafio foi preparar uma camada adequada para análise.
É aqui que entra a Silver.
No notebook:
03_Silver_VRA.ipynb
são executadas as operações necessárias de limpeza, padronização e transformação.
Essa etapa é fundamental porque análises construídas diretamente sobre dados brutos podem reproduzir inconsistências da própria fonte.
A Silver funciona, portanto, como uma camada intermediária entre dados ingeridos e dados prontos para consumo analítico.
Foi também uma etapa importante para exercitar o processamento com Apache Spark e PySpark, trabalhando com transformações de dados dentro do ecossistema Databricks.
5. Gold: quando o dado passa a falar a linguagem do negócio
A camada Gold representa uma mudança importante de perspectiva.
Até aqui, o foco estava principalmente na Engenharia de Dados. Na Gold, a pergunta passa a ser:
“Que informação queremos entregar para quem vai analisar esses dados?”
No notebook:
04_Gold_Analytics.ipynb
foram construídos quatro conjuntos principais de indicadores:
TabelaObjetivokpi_companhiasAnalisar volume e indicadores por companhia aéreakpi_rotasAnalisar operações por rotakpi_aeroportos_origemAnalisar aeroportos de origem e indicadores operacionaiskpi_mensalAcompanhar a evolução temporal das operações
Esse foi um dos pontos mais importantes do projeto.
Em vez de entregar ao usuário final toda a complexidade dos dados transacionais, a Gold fornece estruturas já orientadas às perguntas que queremos responder.
6. Do Analytics para a Inteligência Artificial
Com a camada Gold pronta, seria possível encerrar o projeto construindo dashboards e consultas SQL.
Mas decidi avançar mais uma etapa.
A ideia foi permitir que uma pessoa pudesse explorar os indicadores fazendo perguntas em linguagem natural.
Foi assim que surgiu o:
VoeBem Flight Analytics
O agente foi configurado utilizando Databricks Genie, tendo as tabelas analíticas da camada Gold como base para as consultas.
Isso permite interações como:
Quais são as companhias aéreas com maior número de voos?
Ou:
Quais são as 10 rotas com maior número de voos?
Também podemos perguntar:
Quais são os aeroportos de origem com maior número de voos? Mostre também o atraso médio de partida.
E ainda explorar a dimensão temporal:
Como evoluiu mensalmente o número total de voos?
Aqui acontece uma mudança relevante na experiência de acesso aos dados.
O usuário deixa de precisar conhecer necessariamente a estrutura das tabelas ou escrever uma consulta SQL para começar uma exploração analítica.
Ele pergunta.
A camada de IA interpreta.
Os dados fornecem a resposta.
7. Alguns resultados
Durante a validação do VoeBem Flight Analytics, diferentes dimensões foram testadas.
Companhias aéreas
Na série analisada pelo projeto, TAM, AZU e GLO aparecem com os maiores volumes de voos entre as companhias retornadas pelo indicador.
O objetivo aqui não é apenas produzir um ranking, mas demonstrar que o agente consegue consultar a camada analítica e transformar o resultado em uma resposta compreensível.
Rotas
Outro resultado interessante apareceu na análise das rotas de maior volume.
Entre as primeiras posições estão os dois sentidos da ligação entre:
Santos Dumont (SBRJ) ↔ Congonhas (SBSP)
A análise também mostrou forte presença de Congonhas entre as rotas de maior volume da série considerada.
Evolução mensal
A camada temporal permite acompanhar oscilações no número total de voos ao longo dos meses analisados.
No conjunto processado pelo projeto, por exemplo, janeiro de 2026 apresentou 88.965 voos, enquanto fevereiro de 2026 registrou 77.136.
É importante separar o que os dados demonstram das possíveis explicações para essas variações. Identificar uma oscilação é uma conclusão baseada na série; determinar sua causa exigiria incorporar outras evidências e variáveis.
Esse cuidado também faz parte de uma boa análise de dados.
8. O que a IA acrescentou ao projeto?
Um dos aprendizados mais relevantes foi perceber que adicionar IA a uma solução de dados não significa simplesmente colocar um chatbot na frente de um banco de dados.
Para que uma interação em linguagem natural produza resultados úteis, existe todo um trabalho anterior.
Os dados precisam estar:
organizados → tratados → contextualizados → agregados → preparados para consumo.
Ou seja, o Genie aparece no final da arquitetura, mas depende diretamente da qualidade das etapas anteriores.
Isso reforçou para mim uma percepção importante:
IA Generativa não elimina a Engenharia de Dados. Ela aumenta a importância de uma boa Engenharia de Dados.
Quanto mais confiável e semanticamente organizada for a camada disponibilizada para a IA, melhores tendem a ser as condições para produzir respostas analíticas úteis.
9. Tecnologias utilizadas
O VoeBem Analytics AI permitiu integrar diferentes componentes de uma stack moderna de dados:
Databricks para desenvolvimento e processamento;
Apache Spark e PySpark para transformação distribuída;
Spark SQL e SQL para exploração e construção das análises;
Delta Lake para a arquitetura de armazenamento;
Unity Catalog para organização dos objetos de dados;
Python para processamento;
e Databricks Genie para a camada de interação analítica em linguagem natural.
Mais importante do que utilizar cada tecnologia isoladamente foi compreender como elas se conectam dentro de uma arquitetura de dados.
10. Principais aprendizados
O projeto consolidou alguns conceitos que considero particularmente importantes.
O primeiro foi enxergar a Medallion Architecture como uma separação de responsabilidades, e não simplesmente como três nomes de camadas.
O segundo foi perceber a diferença entre dados preparados para processamento e dados preparados para negócio.
A Silver pode estar tecnicamente limpa e ainda não ser a melhor estrutura para uma pergunta executiva. É justamente aí que a Gold ganha relevância.
O terceiro aprendizado veio da integração com IA.
Para uma solução de Inteligência Artificial trabalhar adequadamente com dados empresariais, a qualidade da resposta começa muito antes do prompt.
Começa na arquitetura.
11. Próximas evoluções
A versão atual marca a v1.0.0 do projeto, mas existem diferentes caminhos possíveis para evolução.
Entre eles estão a construção de um dashboard executivo, ampliação das métricas de atrasos, inclusão de novos períodos, automação da atualização do pipeline, novos indicadores para companhias e aeroportos e evolução da camada de IA.
Essas extensões poderão fazer parte de versões futuras.
Por enquanto, a v1.0.0 representa um pipeline completo e documentado, da ingestão à interação em linguagem natural.
12. Código e documentação
Todo o projeto está disponível publicamente no GitHub:
VoeBem Analytics AI — GitHub
No repositório estão disponíveis os notebooks das camadas Bronze, Silver e Gold, documentação da arquitetura, resultados das consultas realizadas com o VoeBem Flight Analytics e a Release v1.0.0.
Conclusão
O VoeBem Analytics AI começou como um exercício de Engenharia de Dados, mas acabou se tornando algo mais abrangente.
O projeto percorre uma jornada completa:
dados públicos → ingestão → transformação → modelagem analítica → KPIs → Inteligência Artificial → insights de negócio.
E talvez esse tenha sido o principal aprendizado.
Não basta dominar ferramentas isoladamente.
O desafio é entender como conectar tecnologia, dados e contexto de negócio para transformar informação em algo que possa efetivamente ser utilizado.
É nessa interseção entre Engenharia de Dados, Analytics, Inteligência Artificial e Negócios que pretendo continuar aprofundando meus projetos.
Marcus Guedes
GitHub: MCLG1661
LinkedIn: Marcus Corrêa Lopes Guedes
#DataEngineering #Databricks #PySpark #ApacheSpark #DeltaLake #MedallionArchitecture #DataAnalytics #GenerativeAI #Python #SQL