Engenharia de Decisões - Edição #04 - Model monitoring e data drift
- #Machine Learning
- #Data
- #Inteligência Artificial (IA)
Engenharia de Decisões
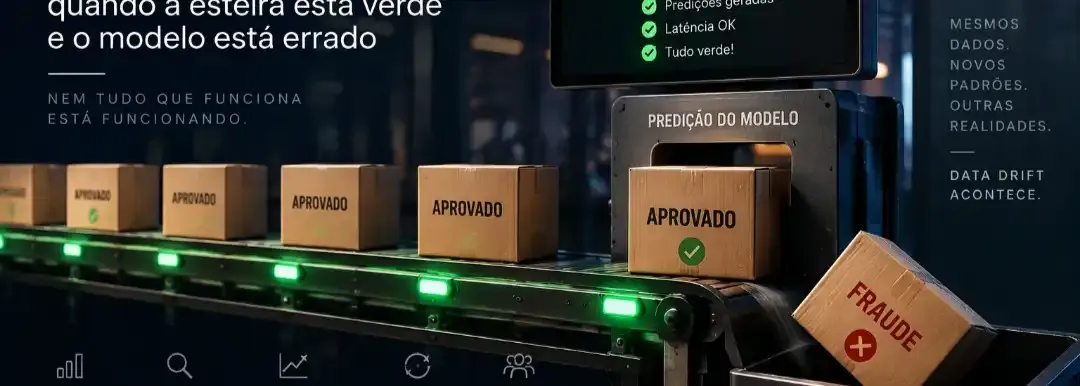
Edição #04 — Model monitoring e data drift: quando a esteira está verde e o modelo está errado
Esta newsletter analisa decisões de engenharia tomadas diante de problemas reais: contexto, critérios, alternativas, trade-offs e evidências. Sem tutorial. Sem lista de ferramentas.
Hoje: o que a esteira de CI/CD da Edição #03 não enxerga, e como decidir o quanto investir em monitoramento depois do deploy.
Baseline
Na Edição #03, discutimos como dimensionar testes, CI/CD e controles de engenharia conforme o risco. Agora, suponha que tudo tenha funcionado: os testes passam, o contêiner sobe, o schema valida e a API responde HTTP 200. O que acontece quando o sistema continua tecnicamente saudável, mas o ambiente para o qual o modelo foi treinado já mudou?
Em sistemas tradicionais, o comportamento tende a permanecer previsível enquanto o código, as configurações, as dependências e os contratos das integrações permanecem estáveis. Ainda assim, testes aprovados não garantem que o sistema continuará adequado a qualquer cenário operacional.
Em ML, há uma dificuldade adicional. O comportamento do modelo depende das distribuições dos dados e das relações que ele aprendeu, e essas relações podem mudar sem que uma linha de código seja alterada.
Essa mudança não precisa provocar uma exceção ou falha técnica. O modelo pode continuar devolvendo previsões válidas do ponto de vista computacional, mas que tenham perdido confiabilidade ou utilidade para a decisão de negócio.
Sem monitoramento adequado, a degradação pode ser percebida apenas depois de uma reclamação de cliente, de uma análise periódica de resultados ou da chegada tardia dos rótulos operacionais (a aproximação disponível do ground truth).
Problema
Como identificar sinais de que um modelo aprovado pela esteira pode estar perdendo desempenho ou adequação ao problema, antes da maturação dos rótulos operacionais, sem afogar a equipe em alertas falsos?
Critérios de Decisão
• Tempo entre a degradação e a detecção, comparado ao tempo de maturação dos rótulos operacionais
• Relevância dos alertas: uma mudança de distribuição pode ser estatisticamente real sem comprometer o desempenho do modelo. O desafio é evitar que todo sinal de drift seja tratado como degradação. Um alerta sem responsável, contexto e ação definida não se transforma em controle operacional
• Interpretação no contexto: o sinal precisa ser lido à luz de sazonalidade, políticas e perfil da população
• Custo esperado do monitoramento, da investigação e da mitigação compatível com a perda esperada que se pretende evitar
Premissas do Modelo
• Modelo econômico didático, não benchmark de mercado. Os valores abaixo são hipóteses explícitas, como na Edição #02. Mudar qualquer premissa muda o resultado. Substitua pelos números da sua operação antes de tirar conclusões.
• Volume: 100.000 transações/mês
• Taxa de transações fraudulentas: 0,5% (500 transações fraudulentas no mês)
• Para simplificar o exercício, considero uma ocorrência de fraude por transação e uma perda média de R$ 1.200 por transação fraudulenta não identificada
• Recall na validação: 80%. Após mudança de comportamento dos fraudadores: 60% (hipótese do cenário, não medição)
• Para isolar o efeito da queda de recall, mantenho constantes a taxa de fraude, o volume mensal e a perda média. A única variável alterada no cenário é o recall
• Rótulo operacional: os registros de chargeback/contestação amadurecem em aproximadamente 60 dias e são utilizados como aproximação do resultado real. Sua cobertura e confiabilidade precisam ser avaliadas
• Prazo hipotético para geração de um alerta acionável por sinais indiretos: aproximadamente 7 dias
• A simulação não considera o custo dos falsos positivos, que também existe.
Alternativas Consideradas
1. Só CI/CD e monitoramento de infraestrutura (latência, erros, CPU). É barato e necessário para verificar a integridade da entrega e a saúde operacional, mas, sem controles específicos em produção, não acompanha mudanças nas distribuições dos dados nem a possível degradação estatística do modelo.
2. Retreino em calendário fixo como principal estratégia de adaptação. É simples de planejar, mas pode retreinar sem necessidade quando o ambiente permanece estável e demorar a reagir quando ocorre uma mudança relevante entre duas execuções programadas.
3. Monitoramento de dados, previsões e indicadores operacionais. Acompanha a distribuição das features, dos scores e de indicadores como a taxa de aprovação. Funciona sem depender da maturação dos rótulos, mas cada sinal tem uma interpretação diferente. Uma mudança na taxa de aprovação, por exemplo, também pode decorrer de alterações nas políticas de decisão ou no perfil da população. São indicadores de investigação, não provas isoladas de degradação.
4. Monitoramento de desempenho com rótulos operacionais. É a avaliação mais direta do desempenho disponível quando os rótulos amadurecem, mas, em crédito e fraude, esses registros podem levar meses para chegar e não representam necessariamente todos os casos.
Decisão
Combinar 3 e 4, em camadas, e separar três decisões distintas:
1. Detectar a mudança: os sinais de dados, previsões e indicadores operacionais funcionam como alarme antecipado.
2. Investigar a causa: falha de dados, mudança de política, sazonalidade, mudança real da população ou do fenômeno.
3. Decidir se retreina, ajusta ou aciona o fallback. O monitoramento de desempenho com rótulos permite verificar se a mudança observada realmente afetou a qualidade das previsões, dentro das limitações de cobertura e confiabilidade desses rótulos.
A decisão não foi monitorar tudo. Foi utilizar sinais indiretos para antecipar a investigação, porque os rótulos operacionais demoram demais para funcionar como alarme.
Evidências
1. Evidência conceitual: drift é sinal, não sentença
• Data drift: ocorre quando a distribuição dos dados de entrada muda em relação à referência de treinamento: P(X) em produção ≠ P(X) no treino.
• Covariate shift é um caso mais específico: P(X) muda e a relação P(Y | X) se mantém. Nem toda mudança nas entradas satisfaz essa hipótese.
• Concept drift: muda a relação entre as entradas e o alvo real: P(Y | X) em produção ≠ P(Y | X) no treino. Sua gravidade depende do problema, da magnitude da mudança, da sensibilidade do modelo e do custo dos erros.
• Dados mudarem não prova que o modelo piorou, e o desempenho pode cair sem que as entradas mudem de forma visível.
• Qualidade de dados é um problema relacionado, mas diferente. Nulos, unidade trocada (centavos lidos como reais) ou formato de data alterado podem gerar uma mudança observável nas distribuições. Isso deve ser tratado primeiro como falha de qualidade ou integridade, e não interpretado automaticamente como mudança legítima do ambiente. A esteira pode validar o schema e ainda deixar passar uma alteração semântica.
2. Evidência técnica: os limiares são convenção
• PSI (Population Stability
Index) amplamente utilizado no acompanhamento da estabilidade de variáveis e scorecards de crédito. Uma regra prática bastante difundida é:
• PSI ≤ 0,1: distribuição semelhante
• 0,1 < PSI ≤ 0,25: mudança moderada; atenção
• PSI > 0,25: mudança mais expressiva; investigar
• Esses valores são referências práticas, não limites universais. O resultado depende, entre outros fatores, da definição das faixas (bins) e das populações comparadas. Um PSI baixo não prova que o ambiente está estável nem que o modelo continua performando bem.
• No contexto específico da avaliação de representatividade em modelos de risco de crédito, o working paper do Global Credit Data apresenta esses cortes como referências identificadas em discussões com instituições participantes, sem tratá-los como recomendações ou padrões universais. O documento orienta que violações de limites quantitativos motivem investigação adicional, em vez de decisões automáticas de exclusão.
• O PSI mede diferenças entre distribuições, não o desempenho do modelo. Um valor elevado indica mudança na população analisada, mas não determina, isoladamente, que o modelo esteja errando mais ou precise ser retreinado.
• Padrões de ferramenta (Evidently): a escolha do método depende do tipo de coluna, do volume de observações e do número de valores únicos. Na configuração padrão documentada, colunas numéricas com mais de 1.000 observações no dataset de referência utilizam a distância de Wasserstein normalizada, com limiar de 0,1. No nível do dataset, o preset sinaliza drift quando pelo menos 50% das colunas avaliadas apresentam mudança. Esses valores são configurações padrão, não limites universais. Métodos, colunas avaliadas e limiares podem ser personalizados conforme o problema.
• Uma ressalva importante: a verificação de data drift do Evidently filtra valores vazios ao comparar as distribuições e, por padrão, não reage a aumentos na quantidade de nulos. Por isso, a própria documentação recomenda complementar a análise com testes específicos de qualidade de dados, incluindo a proporção de valores ausentes.
• Bases grandes: testes de hipótese podem identificar diferenças estatisticamente significativas mesmo quando a mudança tem pouca relevância operacional. Vale combinar significância estatística com medidas de magnitude do efeito, tamanho da amostra e impacto sobre as variáveis importantes para o modelo.
• Sazonalidade: eventos como a Black Friday podem provocar mudanças reais e previsíveis nas distribuições. O monitoramento precisa considerar o calendário e comparar períodos equivalentes, para não confundir sazonalidade conhecida com degradação inesperada.
3. Evidência acadêmica e referências de implementação
• O rubric ML Test Score, do Google (IEEE Big Data, 2017), reúne 28 testes e necessidades de monitoramento para produção e trata monitoramento como parte da prontidão do sistema.
• O survey de Gama et al. (ACM Computing Surveys, 2014) organiza as estratégias de adaptação a concept drift.
• Nas plataformas, o desenho é parecido. O Azure Machine Learning oferece sinais de data drift, prediction drift, data quality, feature attribution drift e model performance, com métricas e limiares configuráveis. Alguns desses recursos, como feature attribution drift e model performance, estão marcados como preview, o que também reforça a necessidade de verificar a maturidade e as limitações de cada recurso antes de adotá-lo em produção.
4. Business Performance (impacto no negócio)
Esta é uma estimativa de exposição potencial, não de economia garantida. Ela pressupõe que a degradação permanece constante, que a perda cresce proporcionalmente ao tempo, que o modelo não sofre outra mudança nesse intervalo e que a equipe consegue executar uma mitigação eficaz após o alerta. Detectar uma mudança não significa, por si só, que a perda será evitada: a operação ainda precisa bloquear, revisar ou adotar outra medida efetiva.
A queda do recall é a hipótese do cenário. Os sinais indiretos antecipam uma investigação, mas não medem essa queda, que só seria confirmada quando os rótulos operacionais amadurecessem.
• Recall de 80%: 400 transações fraudulentas identificadas e 100 não identificadas.
• Recall de 60%: 300 identificadas e 200 não identificadas.
• Perda adicional: 100 × R$ 1.200 = **R$ 120.000/mês**.
• Identificação pelo indicador operacional (~60 dias): **R$ 240.000** de exposição potencial no período.
• Alerta antecipado por sinais indiretos (~7 dias): R$ 120.000 × 7/30 = **R$ 28.000** de exposição potencial no período.
• Diferença de exposição: **≈ R$ 212.000**, potencialmente evitável no cenário hipotético.
Break-even. Com custo ilustrativo de R$ 5.000 por mês, o monitoramento cobre seu custo quando a probabilidade mensal de um evento com essas características é de aproximadamente 2,4% (5.000 ÷ 212.000). Isso compara o custo mensal recorrente do monitoramento com a exposição potencialmente evitada em cada evento. Em uma aproximação de eventos raros e independentes, equivale a uma frequência média próxima de um evento a cada 42 meses.
É uma estimativa simplificada de valor esperado. Pressupõe que o monitoramento gera o alerta no prazo estimado e que a mitigação é eficaz.
• 🔗 Conexão com a Edição #01 (FraudGraph Brasil)
• A regra "≥ 3 CPFs, mesmo dispositivo, mesmo destino Pix" representa um critério de detecção calibrado com base no comportamento observado anteriormente.
• Se o padrão da rede de fraude mudar para 2 CPFs por dispositivo, a regra continuará sendo executada sem erro técnico, mas deixará de identificar parte dos comportamentos que antes cobria.
• Não é necessariamente concept drift de um modelo de ML. É a degradação de uma regra de detecção diante de um padrão que mudou. A esteira continua verde, e a capacidade de identificar aquele comportamento diminui.
Trade-offs Aceitos
• Possibilidade de alertas sem relevância operacional em troca de detecção antecipada. Mitigada com limiares revisados, verificação em lote (diária ou semanal) e alerta ligado a uma ação.
• Retreino com aprovação antes da substituição, mais lento que o automático. Aceito porque uma mudança na distribuição pode decorrer de uma falha de dados, e retreinar sem investigar a causa pode incorporar o problema ao novo modelo. O challenger precisa ser avaliado em dados recentes e representativos, comparado ao champion e aprovado segundo critérios técnicos e operacionais antes de assumir a produção.
• Fallback para regra previamente validada em situações de desvio extremo, aceitando uma possível redução de desempenho enquanto o problema é investigado. A regra alternativa precisa ter comportamento conhecido, limites definidos e procedimento de reversão. Também precisa ser validada para o cenário de contingência e, sempre que possível, não depender da mesma condição que provocou a degradação do modelo.
• Custo de manter logs, baseline e painéis, que também é um controle com custo de manutenção (a regra da #03).
O que mudaria minha decisão
• Se os rótulos operacionais ficassem disponíveis em poucos dias, o monitoramento de desempenho ganharia prioridade e os sinais indiretos poderiam ter menor peso na decisão. Ainda assim, manteria verificações de qualidade e integridade dos dados.
• Se o custo de erro fosse baixo e a variação do ambiente previsível, uma rotina periódica de avaliação e retreino poderia ser suficiente, desde que acompanhada por verificações básicas de qualidade e desempenho.
• Se os alertas passassem a ser ignorados pela equipe, o problema de desenho seria o alerta, não a falta de ferramenta.
Limitações da Análise
A simulação econômica não considera falsos positivos, o custo de investigação de alertas, a incerteza das estimativas e a probabilidade de o monitoramento deixar de detectar um evento. Os registros de chargeback têm cobertura, qualidade e atraso que precisam ser avaliados, pois nem toda fraude gera um registro confirmado. Os limiares de PSI e de dataset drift são ponto de partida e devem ser calibrados no histórico do seu próprio modelo.
Checklist: antes de montar o monitoramento
• [ ] 1. Os dados de entrada, as previsões e as decisões estão sendo registrados?
• [ ] 2. Esses registros têm controle de acesso, prazo de retenção, rastreabilidade e proteção de dados pessoais e informações sensíveis?
• [ ] 3. Existe uma baseline adequada para comparação, com janelas e períodos equivalentes?
• [ ] 4. A qualidade, a integridade e a atualidade dos dados são verificadas separadamente?
• [ ] 5. Em quanto tempo os rótulos operacionais amadurecem? Se o atraso for elevado, quais sinais indiretos podem antecipar uma investigação?
• [ ] 6. Cada alerta tem responsável, critério de severidade e ação definida?
• [ ] 7. O custo esperado do monitoramento, da investigação e da mitigação é compatível com a perda esperada que se pretende evitar?
• [ ] 8. Existe um procedimento definido para reduzir o tráfego, reverter o modelo ou acionar uma alternativa segura em caso de degradação crítica?
Se o atraso dos rótulos for elevado, os sinais indiretos podem ser necessários para antecipar a investigação. Nem toda aplicação precisa de monitoramento estatístico sofisticado: o desenho deve acompanhar o risco e a capacidade de agir.
Aprendizados
• O deploy marca o começo da observação, não o fim do trabalho.
• "Tudo verde" na esteira mostra que o modelo foi entregue corretamente. Não mostra que ele continua adequado ao problema.
• Detectar uma mudança, investigar sua causa e decidir retreinar são três decisões diferentes.
• Os limiares que circulam na internet são convenções. Medir no seu histórico vale mais do que copiar o número de um tutorial.
Próxima edição
Champion/Challenger e retreino automático: quando automatizar a correção é pior que o problema.
• E por aí?
• Na sua operação, o monitoramento de data drift costuma gerar alertas úteis ou acaba virando apenas mais um painel ignorado pela equipe? Deixe seu comentário.
Fontes e Referências
• [Breck et al., Google Research — The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction (IEEE Big Data, 2017)](https://research.google/pubs/pub46555/)
• [Gama et al. — A Survey on Concept Drift Adaptation (ACM Computing Surveys, 2014)](https://doi.org/10.1145/2523813)
• [Global Credit Data — Guidelines on Assessing Representativeness in Credit Risk Modelling (working paper, v1.1, 2025)](https://globalcreditdata.org/wp-content/uploads/2025/05/gcd-representativeness_guidelines_v1.1.pdf)
• [Evidently AI — Data drift: como funciona o algoritmo padrão](https://docs.evidentlyai.com/metrics/explainer_drift)
• [Evidently AI — Customize Data Drift (métodos, limiares e drift_share)](https://docs.evidentlyai.com/metrics/customize_data_drift)
• [Microsoft Learn — Model monitoring with Azure Machine Learning](https://learn.microsoft.com/azure/machine-learning/concept-model-monitoring)
• Leituras complementares: [Evidently AI — Which test is the best? 5 métodos de drift em bases grandes](https://www.evidentlyai.com/blog/data-drift-detection-large-datasets) · [Evidently AI — "My data drifted. What's next?"](https://www.evidentlyai.com/blog/ml-monitoring-data-drift-how-to-handle)
Valores monetários e premissas são ilustrativos. Limiares e padrões de ferramentas podem mudar entre versões: consulte a documentação vigente.
Engenharia de Decisões — arquitetura, trade-offs e evidências reais em Cloud, IA e Dados.
#MLOps #MachineLearning #DataDrift #ModelMonitoring #EngenhariaDeDados