Engenharia de Decisões - Edição #03 — Docker, CI/CD e suíte de testes
- #Docker
Engenharia de Decisões
Edição #03 — Docker, CI/CD e suíte de testes: maturidade técnica ou sobre-engenharia disfarçada?
Esta news analisa decisões de engenharia tomadas diante de problemas reais. Cada edição apresenta o contexto, os critérios de decisão, as alternativas avaliadas, os trade-offs aceitos e as evidências que sustentam a escolha.
Sem tutorial. Sem lista de ferramentas. Decisão, critério, evidência, resultado.
Hoje: a esteira de MLOps — Docker, CI/CD e testes automatizados — e o momento certo de investir nela.
Baseline
Existe um consenso quase automático no mercado: "projeto sério tem Docker, CI/CD e testes". Esse consenso faz sentido quando um modelo precisa ser reproduzível, testável, implantável e operado continuamente. O problema começa quando essas práticas deixam de ser respostas a riscos concretos e passam a ser tratadas como requisito obrigatório desde o primeiro experimento.
O ponto relevante para esta análise é outro: quando um modelo já precisa operar de forma recorrente, reproduzível e controlada, práticas de MLOps passam a tratar riscos que simplesmente não existem — ou ainda não são relevantes — durante a exploração inicial. Uma equipe pode gastar três semanas configurando pipelines de CI/CD e imagens Docker multi-stage para um modelo que ainda não demonstrou valor preditivo — isso representa cerca de 360 horas de engenharia, antes mesmo de considerar o custo de manutenção, investidas em uma hipótese que poderia ser descartada em 48 horas de exploração simples com notebook e Git.
A esteira de MLOps não é boa ou má em si. Ela é uma resposta a riscos específicos. Aplicada no momento certo, é maturidade. Aplicada cedo demais, é sobre-engenharia disfarçada de boas práticas.
Problema
Como decidir quando investir em Docker, CI/CD e suíte de testes automatizados em um projeto de Machine Learning, de forma que a esteira acelere a entrega em vez de atrasar a validação da hipótese de negócio?
Critérios de Decisão
A pergunta não é "toda equipe madura usa essas ferramentas?". É:
- Qual é o gargalo atual do projeto: validar se o modelo tem valor, ou entregar com confiabilidade um modelo que já provou valor?
- Existe usuário real, sistema crítico ou múltiplos colaboradores dependendo do código?
- A instabilidade de ambiente (dependências, versões de bibliotecas) já causou falhas reais, ou é um risco hipotético?
- O custo de configurar a esteira é menor do que o custo do risco que ela mitiga?
Esses critérios — e não a adoção de ferramentas como símbolo de senioridade — é que deveriam decidir a arquitetura.
Alternativas Consideradas
Notebook + Git simples. Ambiente local, controle de versão básico, sem containerização nem automação. Adequado para exploração de dados e validação de hipótese. Baixíssimo custo de setup, mas reprodutibilidade limitada fora do ambiente de desenvolvimento.
Scripts estruturados + Dockerfile básico + testes de contrato e validação de entrada/saída. O notebook vira código Python organizado. Um Dockerfile reduz a dependência do ambiente local e aumenta a reprodutibilidade da execução. Testes simples validam schema, tipos de dados e formato da resposta — sem ainda cobrir treinamento ou deploy. Fricção intermediária, ainda sem automação de deploy.
Esteira de entrega automatizada: Docker + CI/CD + suíte de testes (unitários, integração, validação de modelo). As alterações passam por validações automatizadas e podem ser empacotadas e promovidas entre ambientes conforme as políticas de entrega. Exige tempo de configuração e manutenção contínua, mas elimina deploy manual e regressões silenciosas.
Decisão
Adotar uma evolução gradual em três fases, associando cada camada de infraestrutura a um risco concreto que ela resolve — não à fase do projeto por padrão arquitetural:
1. Descoberta (PoC): Git e ambiente local, com foco em validar a hipótese e a qualidade do sinal nos dados. PoC não significa bagunça: pode incluir Git, README, ambiente virtual, `requirements.txt`, notebook organizado, baseline, métricas e validação dos dados — sem necessariamente ter Docker, CI, CD ou registry. Testes automatizados são introduzidos apenas quando o código passa a ser reutilizado ou quando uma falha de lógica ameaça a velocidade da experimentação. Validação cruzada avalia o comportamento do modelo — ela não substitui testes de software, que verificam se uma função continua fazendo o que deveria fazer.
2. Operacionalização (MVP): o notebook vira script estruturado. Um `requirements.txt` ou Dockerfile básico garante que o código rode fora da máquina de origem. Testes de contrato validam schema, tipos e formato de entrada e saída dos dados.
3. Produção e escala (MLOps mais completo): CI/CD, testes de dados, testes de modelo, gestão de artefatos, deploy automatizado e mecanismos de monitoramento e rollback, conforme os riscos do sistema.
A decisão não foi "MLOps sempre" nem "MLOps nunca" — foi específica ao critério definido acima: cada componente da esteira existe para controlar um risco, e um risco que ainda não foi identificado ou materializado pode não justificar o mecanismo que o controla.
Antes de investir em automação operacional, existe um pré-requisito anterior: o modelo precisa demonstrar que existe valor mensurável a ser operacionalizado — normalmente comparado a um baseline, uma regra de negócio simples ou uma versão anterior. Isso não significa que toda infraestrutura deva esperar pelo baseline: um risco concreto de reprodutibilidade, colaboração ou segurança pode justificar controles antes disso. A infraestrutura de produção não é o primeiro investimento de maturidade; é a resposta a um problema cujo valor e riscos já justificam o controle.
Trade-offs Aceitos
- Menor rigor de infraestrutura na fase de descoberta — aceito porque, sem validação de hipótese, qualquer investimento em Docker ou CI/CD é esforço sobre um projeto que pode ser descartado em dias.
- Reescrita de Dockerfiles e pipelines ao migrar de fase — aceito porque tentar antecipar a arquitetura de produção durante a experimentação cria atrito exatamente no momento em que a equipe mais precisa de velocidade para testar hipóteses.
- Maior complexidade operacional na fase de produção (manutenção de pipelines, monitoramento, gestão de containers) — aceito porque, nesse estágio, o custo de uma falha de ambiente ou de uma regressão não detectada é maior do que o custo de manter a esteira.
- Threshold de métricas do modelo tratado com cautela — uma métrica de qualidade previamente definida pode funcionar como gate de CI, mas não deve ser aplicada de forma rígida a ponto de rejeitar um modelo com desempenho de negócio superior por não atingir um único indicador isolado.
Regra de Decisão
Todo controle de engenharia tem um custo — não apenas de implementação, mas de manutenção contínua: Docker exige atualização de imagem e patches de segurança; CI exige manter e monitorar a pipeline; testes exigem ser escritos, atualizados e revisados; CD exige gestão de secrets, permissões e observabilidade do processo de rollback. O erro não é implementar controles. O erro é ignorar o custo de mantê-los.
Isso permite formalizar a decisão como uma regra simples:
• Introduza uma camada de engenharia quando o custo esperado do risco que ela reduz for maior do que o custo de implementar e manter essa camada. Caso contrário, mantenha a simplicidade.
Essa regra é o que torna a decisão auditável — não depende de quão "profissional" uma arquitetura parece, mas de uma comparação explícita entre custo do risco e custo do controle.
Evidências
Evidência de convergência entre provedores — o modelo de maturidade em níveis
Google Cloud, AWS, Microsoft Azure e Red Hat utilizam taxonomias diferentes para MLOps, mas convergem em um princípio comum: a automação deve ser progressiva, aumentando conforme crescem as necessidades de confiabilidade, repetibilidade e operação em escala.
- Google Cloud e AWS: definem 3 níveis explícitos — Nível 0 (processo manual), Nível 1 (pipeline automatizado com treinamento contínuo) e Nível 2 (CI/CD completo de ponta a ponta).
- Microsoft Azure: adota um modelo mais granular, de 5 níveis de capacidade técnica — de "No MLOps" a "Full MLOps automated operations" — e detalha um nível intermediário, "DevOps, mas sem MLOps", em que builds e testes do código de aplicação já são automatizados, mas o treinamento e a implantação de modelos continuam manuais. Esse nível é compatível com uma parte da fase de MVP descrita nesta análise, especialmente quando o código da aplicação já possui automação, mas o ciclo de treinamento e implantação do modelo ainda permanece manual. A Microsoft explicita ainda que o modelo deve ser usado para progredir gradualmente: as organizações podem apresentar características de mais de um nível simultaneamente, em um continuum, e não em uma sequência rígida de etapas isoladas.
- Red Hat: categoriza tanto os estágios do ciclo de vida de um modelo quanto a maturidade por nível de automação, descrevendo três níveis de progressão do fluxo manual até o CI/CD pleno.
Esses modelos não descrevem a maturidade como um salto direto para a automação máxima: eles apresentam uma progressão de capacidades, da operação manual para níveis crescentes de automação e controle. Essa convergência sustenta a decisão de evoluir a esteira conforme aumentam os riscos e as necessidades operacionais — não como prova definitiva da decisão, mas como evidência compatível com ela.
Evidência de risco — cada componente controla um problema específico
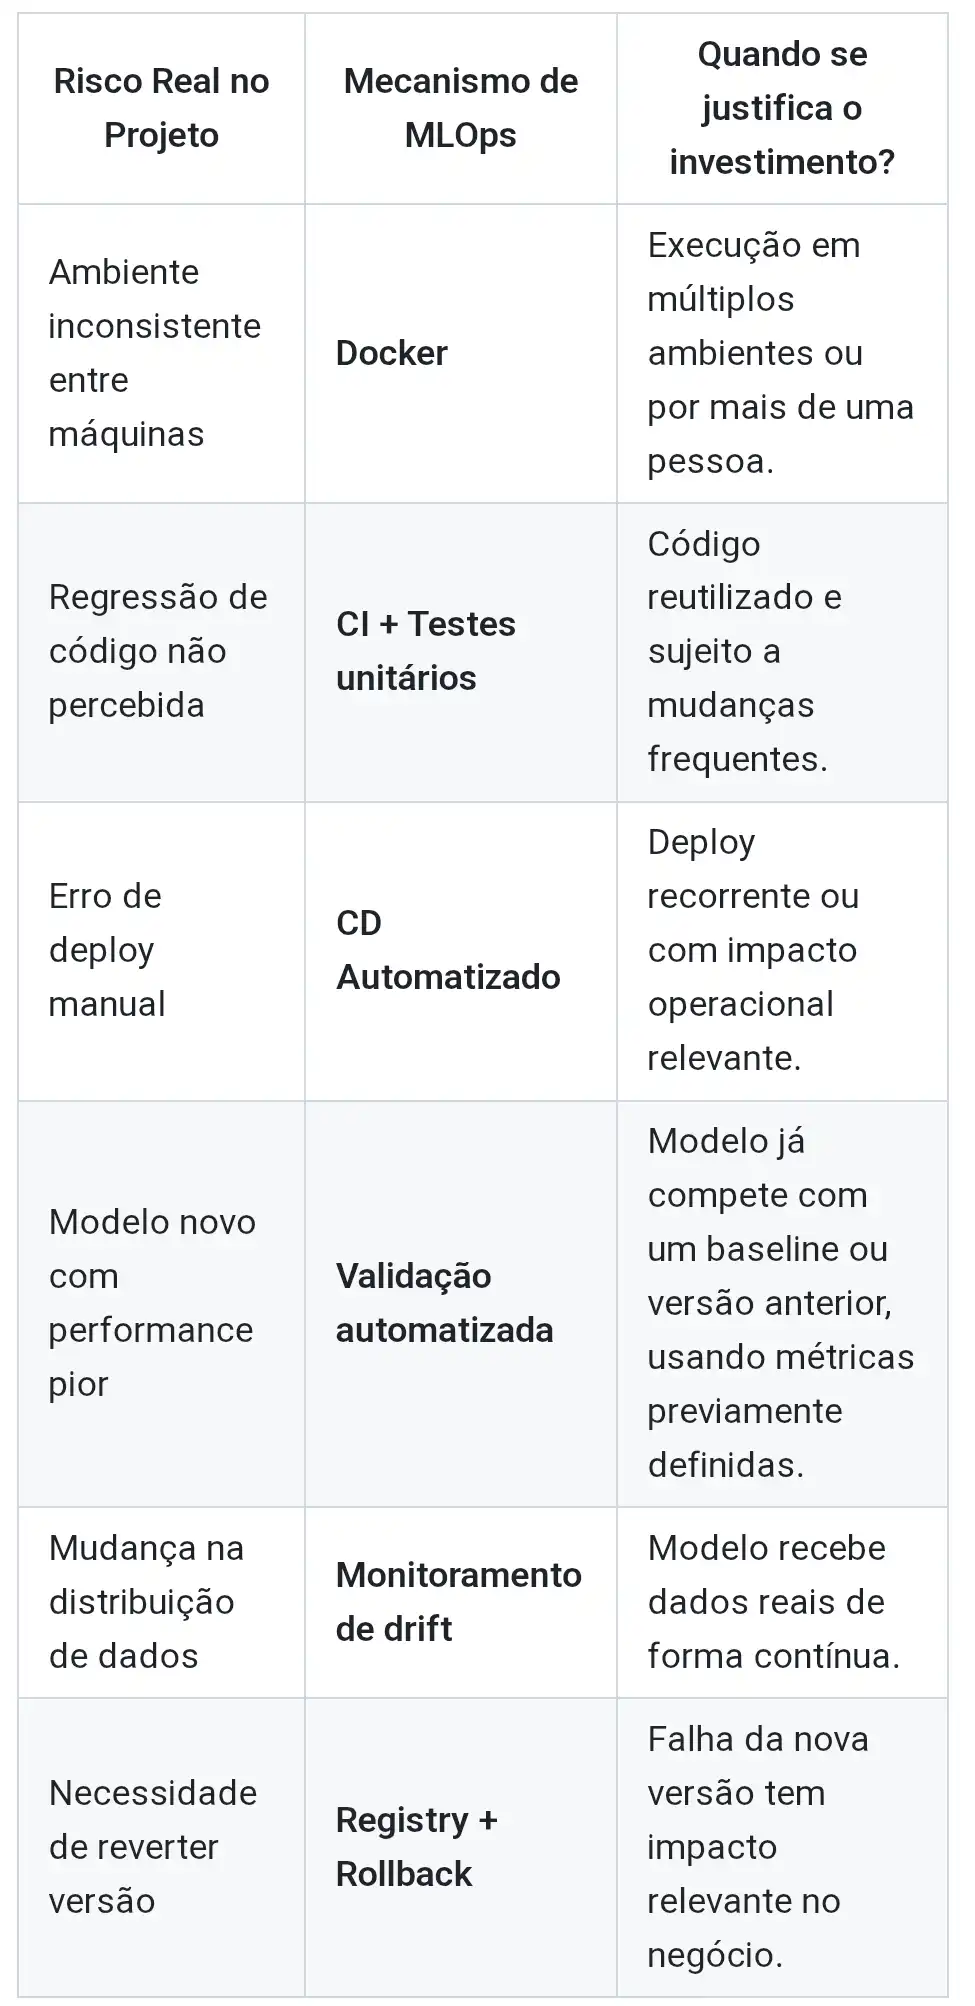
Essa é a diferença entre "ter a ferramenta" e "controlar o risco": um Dockerfile em um projeto que ainda não apresenta necessidade concreta de reprodutibilidade entre ambientes pode não estar controlando um risco proporcional ao seu custo de manutenção — pode estar apenas adicionando complexidade antes da hora. Isso não significa que Docker exija produção, API ou usuário real: mesmo em um projeto de pesquisa sem nenhum desses três, a divergência de versões de bibliotecas entre máquinas diferentes já é, por si só, um risco legítimo de reprodutibilidade.
Cenário ilustrativo — o custo de inverter a ordem
Considere um cenário hipotético de previsão de churn: uma equipe investe semanas configurando Docker, CI/CD e validação automatizada antes do primeiro treinamento. Ao rodar o modelo pela primeira vez, na quarta semana, descobre-se que os dados históricos disponíveis não têm sinal preditivo suficiente — o modelo performa pior do que a média histórica usada como baseline. Resultado: toda a infraestrutura criada gera custo de manutenção, mas zero valor entregue ao negócio, porque o projeto é descontinuado antes de qualquer modelo chegar perto de superar o baseline. A ordem correta seria inversa: validar o sinal nos dados em dias, com notebook e Git, antes de qualquer linha de Dockerfile.
Limitações da Análise
Esta análise não defende que projetos pequenos devam permanecer sem testes ou sem reprodutibilidade. O ponto de decisão não é o tamanho do projeto, mas a relação entre risco, custo de falha, frequência de mudança, número de ambientes envolvidos e custo de manutenção dos controles. Um projeto pequeno com alta frequência de mudança e múltiplos colaboradores pode justificar CI antes de um projeto maior que roda sozinho, em um único ambiente, sem mudanças frequentes. A tese central não é "PoC não precisa de qualidade" — é que qualidade e automação devem ser proporcionais ao risco real, não ao tamanho ou à aparência de maturidade do projeto.
Em sistemas de ML, o risco não é apenas operacional: qualidade dos dados, leakage, viés, segurança, requisitos regulatórios e impacto financeiro também podem justificar controles adicionais mesmo antes de uma implantação em larga escala.
Checklist de Validação Antes do Primeiro Dockerfile
Antes de escrever a primeira linha do seu Dockerfile ou configurar o `.github/workflows`, responda:
• [ ] 1. O modelo já supera um baseline mensurável?
• [ ] 2. O código já é reutilizado, alterado frequentemente ou compartilhado por mais de uma pessoa?
• [ ] 3. Existe risco concreto de incompatibilidade ou dificuldade de reprodução do ambiente?
• [ ] 4. O modelo será integrado a um sistema ou fluxo operacional real?
• [ ] 5. O custo de automatizar é menor que o custo esperado das falhas que a automação pretende evitar?
Quanto mais respostas forem SIM, maior é o caso para introduzir controles de engenharia. Mas não existe um número mágico de respostas: a decisão depende do risco que cada controle reduz.
Impacto
O ganho de tratar a esteira de MLOps como resposta a risco, e não como checklist obrigatório, é duplo: evita semanas de esforço de infraestrutura sobre hipóteses ainda não validadas, e aumenta a probabilidade de que a automação seja introduzida quando seu custo passa a ser menor do que o risco que ela ajuda a controlar.
• A pergunta certa nunca é "preciso de CI/CD?". É "qual risco estou tentando controlar, e esse risco já existe no meu projeto?"
Essa reformulação transforma a escolha de ferramentas em uma decisão auditável — a mesma lógica de Baseline, Critérios, Alternativas e Trade-offs que sustenta as duas primeiras edições desta newsletter, agora aplicada à própria forma de construir e entregar um projeto de ML.
Próxima edição
Model monitoring e data drift: como saber se um modelo que passou em todos os testes de CI/CD ainda está certo — e por que uma esteira impecável pode estar entregando previsões erradas de forma automatizada.
Fontes e Referências
- [Google Cloud — MLOps: pipelines de entrega contínua e automação no aprendizado de máquina](https://docs.cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning?hl=pt-br) — níveis de maturidade 0, 1 e 2
- [AWS — O que é MLOps?](https://aws.amazon.com/pt/what-is/mlops/) — práticas para automatizar e padronizar desenvolvimento, testes, integração, release e infraestrutura
- [Databricks — MLOps vs DevOps: um guia prático](https://www.databricks.com/br/blog/mlops-vs-devops) — definição de MLOps combinando DevOps, DataOps e ModelOps
- [Microsoft Azure — Modelo de maturidade do MLOps](https://learn.microsoft.com/pt-br/azure/architecture/ai-ml/guide/mlops-maturity-model) — modelo de 5 níveis (0 a 4) e evolução incremental
- [Red Hat — O que é MLOps?](https://www.redhat.com/pt-br/topics/ai/what-is-mlops) — MLOps como evolução do DevOps e níveis de automação
Classificações de maturidade citadas nesta edição refletem a documentação oficial dos provedores até a data de publicação — consulte as fontes para eventuais atualizações.
Engenharia de Decisões — arquitetura, trade-offs e evidências reais em Cloud, IA e Dados.