Paradigma Procedural vs. Orientado a Objetos: Lições Práticas de uma Transição
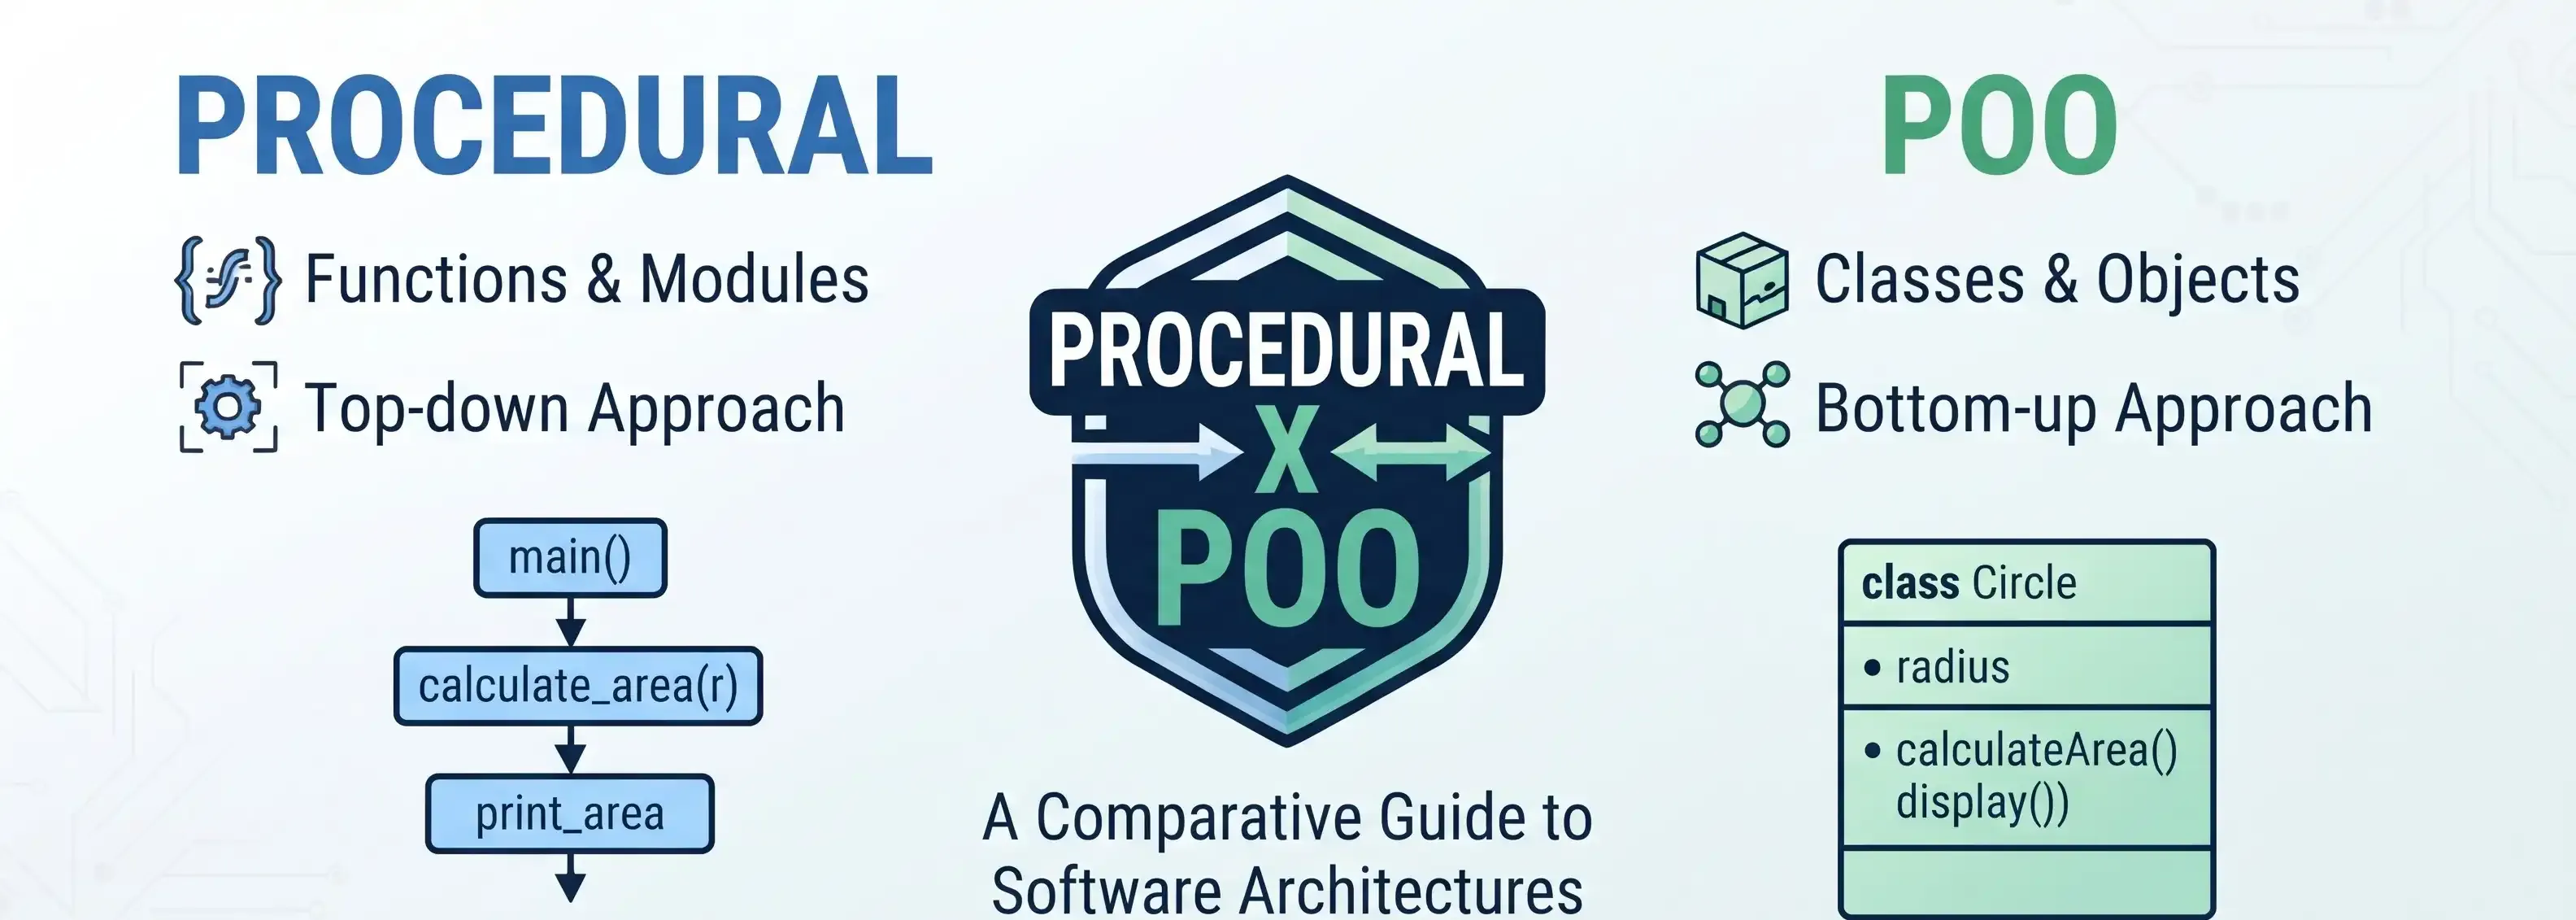
A transição entre linguagens orientadas a objetos consolidadas — como Java e Ruby — e o universo procedural em C costuma ser tratada apenas como um desafio de sintaxe ou de gerenciamento manual de ponteiros e memória. Contudo, essa mudança envolve, antes de tudo, uma virada de perspectiva arquitetural: passar de um modelo mental centrado em entidades autocontidas para um modelo fundamentado no fluxo explícito de instruções e transformações de dados.
A cultura dominante na indústria e o discurso comum de ferramentas de inteligência artificial costumam propagar uma hierarquia simplista: a programação procedural seria um estágio rudimentar, adequado apenas a scripts lineares, enquanto a Orientação a Objetos (POO) representaria o padrão indispensável para lidar com sistemas complexos. Evidências empíricas e marcos históricos da engenharia de software desmentem essa premissa.
1. Entidades vs. Fluxos: A Separação entre Estado e Algoritmo
Em Java e Ruby, a arquitetura é guiada pelo princípio de encapsulamento: classes agregam tanto o estado interno (atributos) quanto os comportamentos (métodos). Uma rotina financeira, por exemplo, é modelada como uma classe Contabancaria com saldo privado e métodos específicos para realizar operações, garantindo que o acesso ocorra exclusivamente através de interfaces controladas.
Em C, essa união intrínseca entre dados e rotinas é desfeita:
- Desacoplamento explícito: Dados residem em estruturas passivas (sructs ou variáveis de escopo), enquanto as funções operam como transformadores externos que recebem parâmetros e devolvem resultados.
- Transparência de execução: Em vez de invocar mensagens cujo impacto sobre o estado pode ser mascarado por cadeias de métodos internos, o fluxo procedural evidencia a ordem cronológica exata do processamento.
- Transporte de contexto: A ausência de atributos implícitos exige que cada dado necessário seja passado de forma transparente entre chamadas, evitando efeitos colaterais ocultos dentro de instâncias.
Essa abordagem aproxima o desenvolvedor da mecânica real do computador: o software é compreendido como uma sequência organizada de instruções executadas sobre a memória, e não como uma rede abstrata de agentes autônomos.
2. Evidências Empíricas: O Mito do Suporte à Complexidade
O argumento clássico de que apenas a Orientação a Objetos é capaz de sustentar projetos de grande escala é refutado pela própria infraestrutura do software moderno. O kernel do Linux, um dos projetos mais extensos, concorrentes e críticos do mundo, é implementado integralmente em C. Sua longevidade e robustez comprovam que o paradigma procedural é plenamente capaz de gerenciar alta complexidade quando apoiado em convenções rigorosas de modularidade.
Além de contraexemplos práticos, pesquisas acadêmicas e medições industriais apontam nuances cruciais sobre a eficácia dos dois modelos:
- Compreensão em tarefas complexas: Estudos empíricos que avaliaram a capacidade de assimilação de programadores iniciantes revelaram que, embora códigos triviais em POO fossem bem compreendidos, a introdução de maior complexidade conferiu nítida vantagem ao código procedural. Iniciantes demonstraram maior facilidade para rastrear a execução e explicar o comportamento do software quando as rotinas estavam organizadas de forma sequencial, sem a fragmentação imposta por múltiplas classes e hierarquias.
- Métricas de produtividade: Avaliações corporativas históricas, como estudos conduzidos pela IBM comparando entregas comerciais em diferentes paradigmas, não identificaram saltos determinantes de produtividade pelo simples uso de POO em relação a um desenvolvimento procedural disciplinado.
3. A Armadilha da Abstração Excessiva e a Gestão de Estado
A facilidade com que linguagens como Java e Ruby permitem introduzir camadas abstratas constitui tanto sua força quanto seu principal risco. Ao incentivar o uso extensivo de interfaces, adaptadores, classes abstratas e fábricas, esses ecossistemas frequentemente caem na armadilha da estratificação excessiva (excessive layering).
Criar uma nova classe ou nível de indireção tem custo de atrito muito baixo, levando arquiteturas a dispersar a lógica de negócio essencial através de dezenas de arquivos e chamadas intermediárias. Em contrapartida, desenvolvedores em C tendem a manter a lógica próxima aos dados fundamentais, reduzindo indireções que nada agregam ao problema concreto.
Entretanto, o modelo procedural traz seus próprios desafios de manutenção:
- Rastreabilidade de mutações: Sem modificadores de acesso formais (private, protect), dados compartilhados podem ser alterados por qualquer procedimento, tornando a depuração desafiadora em bases de código desorganizadas.
- Ecossistema e bibliotecas: Java e Ruby destacam-se pela maturidade de seus ecossistemas de testes, frameworks web e gerenciamento automático de memória (Garbage Collector), elementos que aceleram a entrega de sistemas empresariais em comparação com o ferramental de baixo nível de C.
A fonte primária de defeitos e perda de legibilidade em software reside na mutação descontrolada de estado compartilhado, e não na escolha sintática entre funções ou métodos.
4. Síntese Prática para a Transição
A escolha entre paradigmas não deve ser pautada por dogmas, mas pela natureza do problema técnico e pelas restrições de desempenho e manutenibilidade.
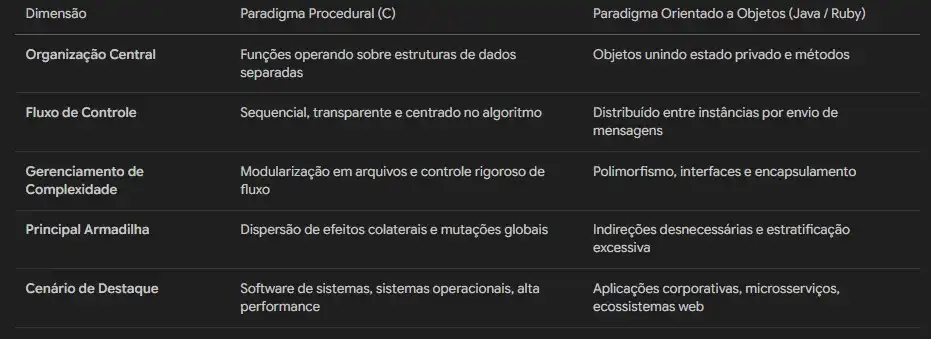
Pra quem domina Java ou Ruby e passa a explorar C, a principal lição prática é que nenhum paradigma é intrinsecamente superior: sistemas elegantes resultam da disciplina no controle de estado e da clareza do fluxo de dados, qualidades que independem do uso de classes.