
Previsão de Sobreviventes do Titanic: Comparação entre Modelos de Classificação Clássicos
- #Pandas
- #Machine Learning
- #Data
- #Python
- #scikit-learn
https://www.kaggle.com/writeups/hudsondossantostamio/reviso-de-sobreviventes-do-titanic-comparao-en
www.linkedin.com/in/hudson-tamião
### Antecedentes
Este projeto foi desenvolvido com base na clássica competição do Kaggle "Titanic - Machine Learning from Disaster". O objetivo principal é desenvolver um modelo preditivo capaz de determinar a sobrevivência dos passageiros com base em suas características, utilizando a acurácia como métrica principal de avaliação (a porcentagem de passageiros previstos corretamente).
### Narrativa do projeto
A abordagem começou com uma Análise Exploratória de Dados (EDA) automatizada, utilizando a biblioteca ydata-profiling para gerar um relatório interativo e compreender rapidamente as distribuições e os valores ausentes do conjunto de dados de treino.
Durante o tratamento dos dados, tomei as seguintes decisões:
- Remoção de alta cardinalidade: Excluí as colunas Name, Ticket e Cabin, pois a alta variação de texto e códigos poderia prejudicar a generalização do modelo.
- Imputação de valores nulos: Preenchi os valores vazios da idade (Age) e da tarifa (Fare) utilizando a média de seus respectivos conjuntos numéricos. Para o porto de embarque (Embarked), os valores vazios foram substituídos pela moda (o valor mais frequente).
- Mantive a modelagem focada exclusivamente nas colunas numéricas restantes.
Para a construção preditiva, a base foi dividida em dados de treino e validação (80/20). Testei e comparei três algoritmos clássicos do scikit-learn:
- Árvore de Classificação (Decision Tree)
- KNeighborsClassifier (KNN com 3 vizinhos)
- Regressão Logística (Logistic Regression)
### Conclusões
Avaliando os modelos nos dados de validação através da Acurácia e da Matriz de Confusão, obtivemos os seguintes resultados:
- Árvore de Classificação: ~64,24% de acurácia.
- KNN: ~66,48% de acurácia.
- Regressão Logística: ~73,18% de acurácia.
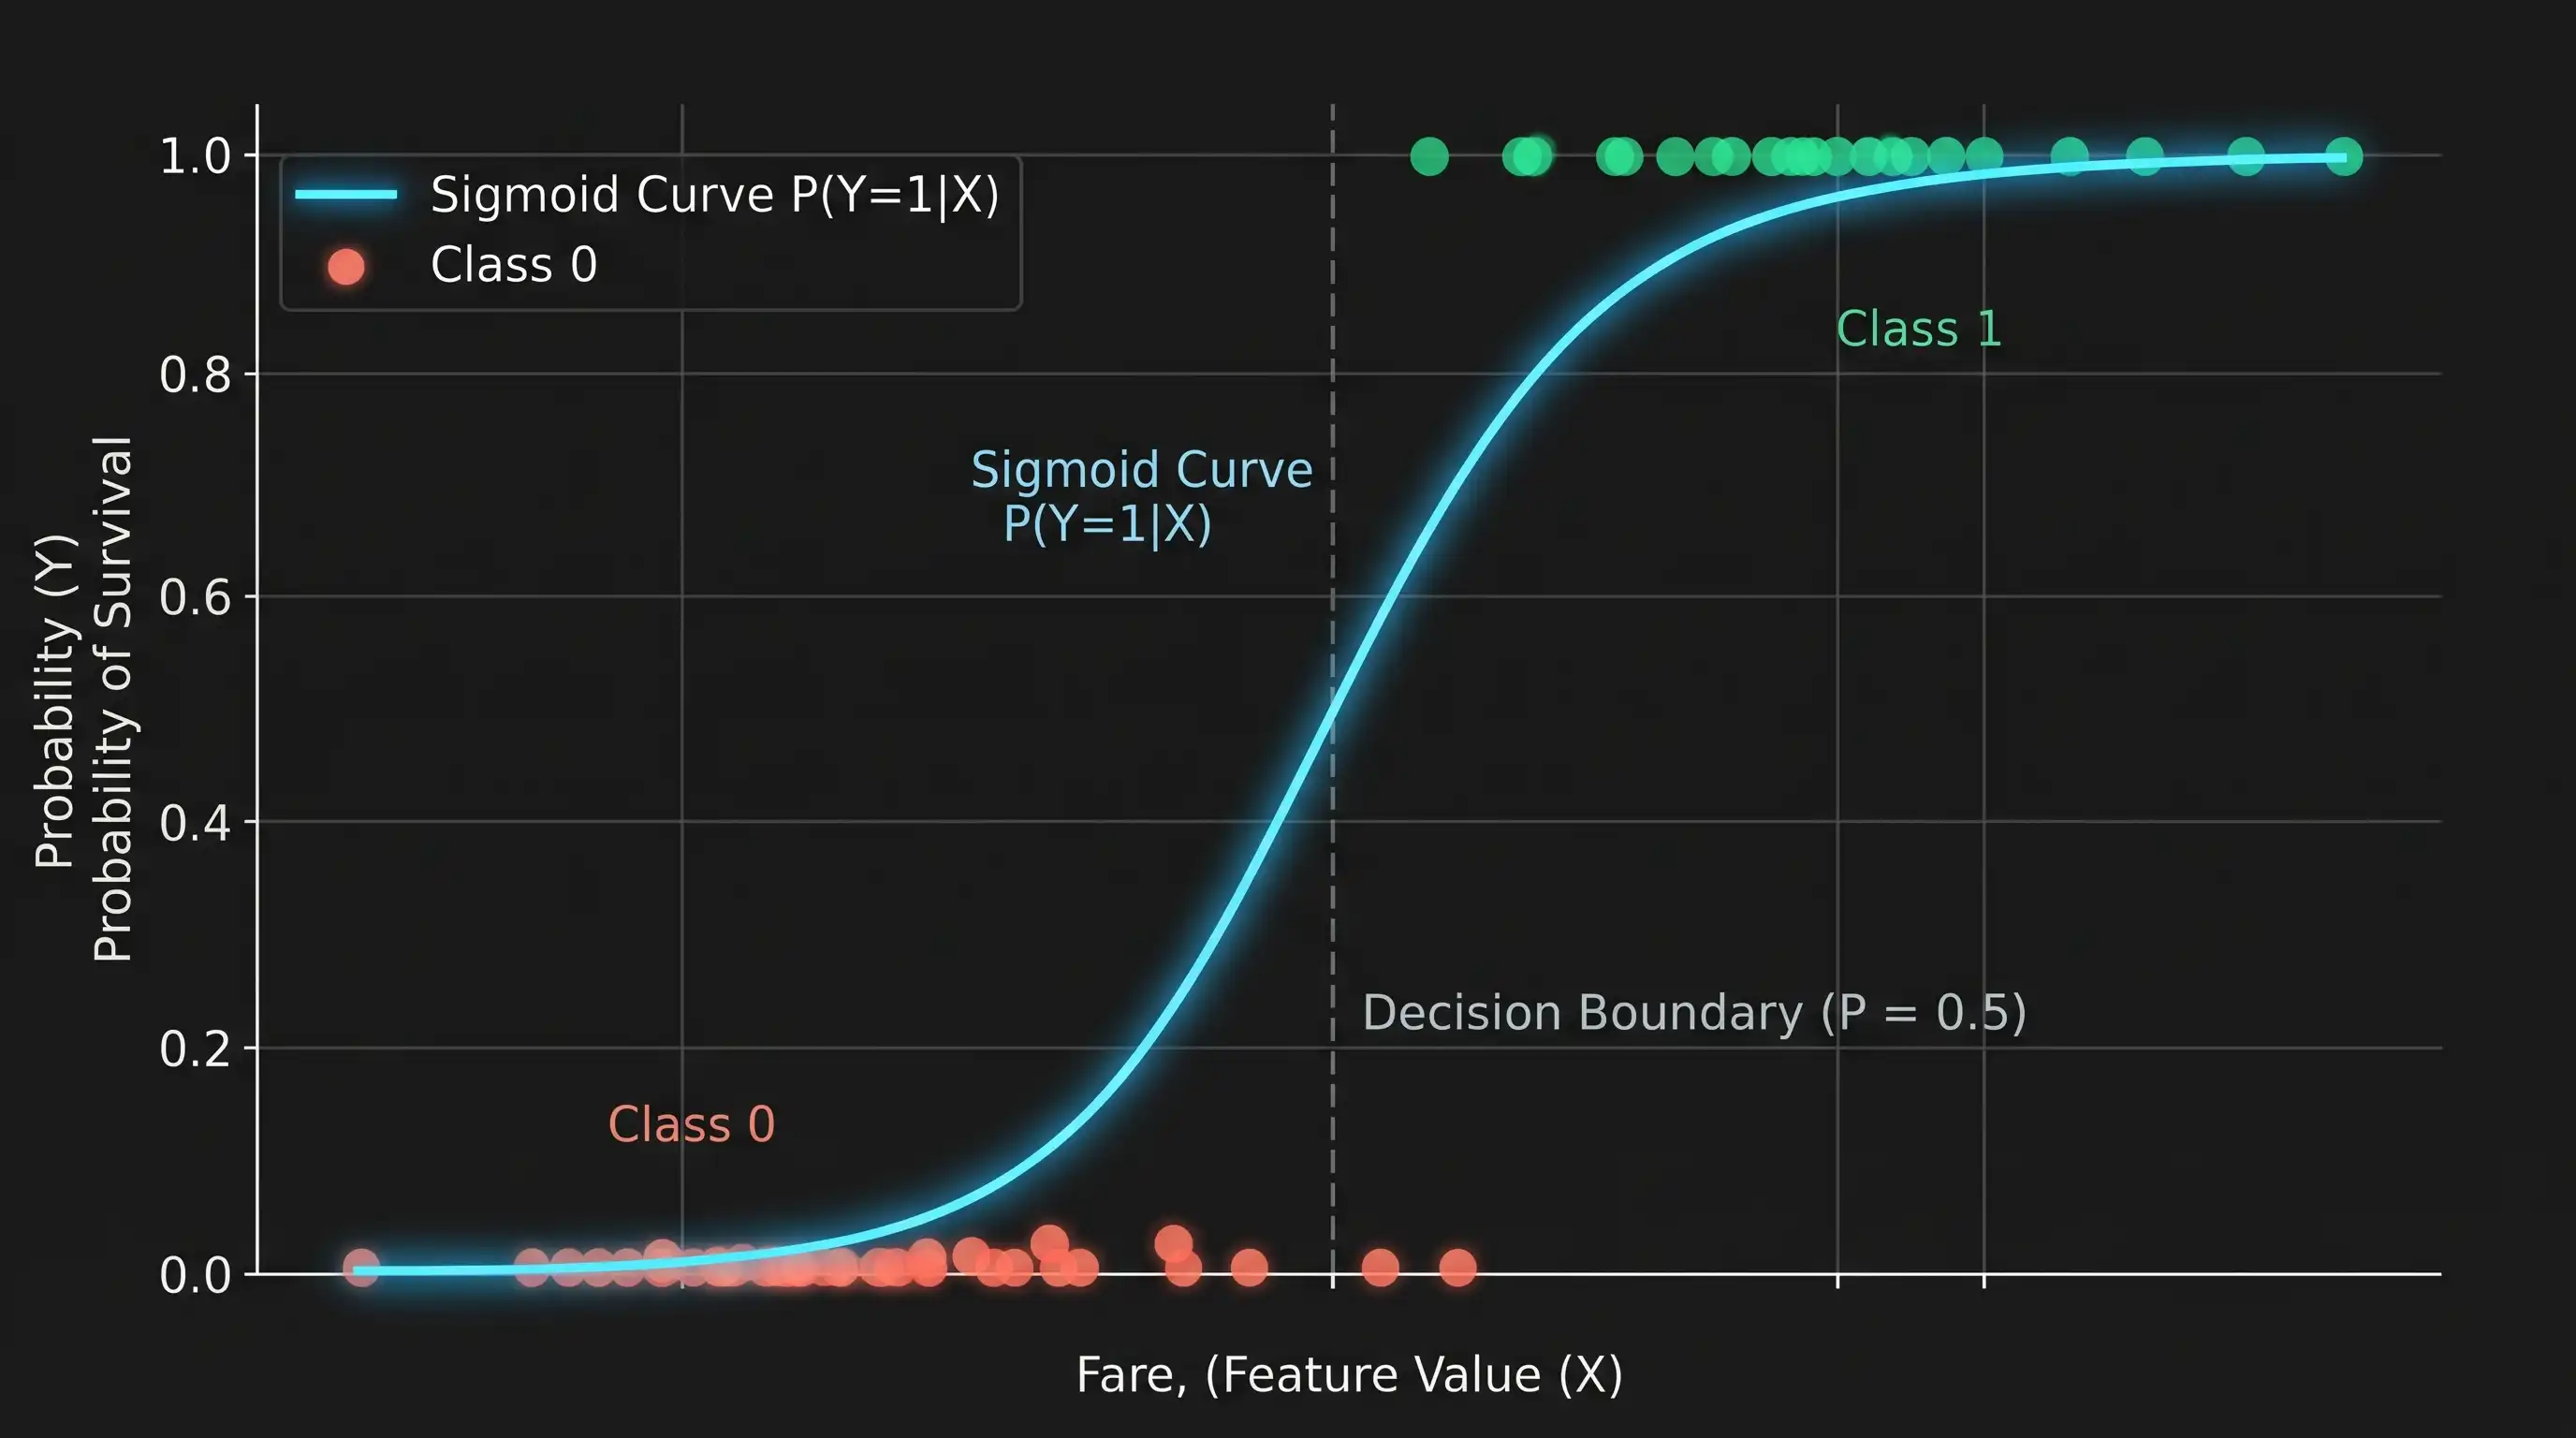
A Regressão Logística demonstrou ser o modelo mais robusto e eficaz para este conjunto de features numéricas. Portanto, utilizei este algoritmo para realizar as previsões finais na base de teste, exportando os resultados formatados no arquivo resultados3.csv para submissão. Como melhoria futura, iteraria sobre a base aplicando engenharia de recursos (feature engineering) nas variáveis categóricas (como o sexo do passageiro) utilizando One-Hot Encoding, o que provavelmente aumentaria ainda mais o poder preditivo do modelo.